El aprendizaje few-shot, también conocido como few-shot learning (FSL), es un enfoque de aprendizaje automático que permite a un modelo reconocer patrones y afrontar tareas nuevas utilizando muy pocos ejemplos etiquetados. Resulta especialmente útil cuando reunir miles de muestras es caro, lento o sencillamente imposible. Aunque suele aplicarse a problemas de clasificación, también se investiga en detección de objetos, procesamiento del lenguaje y robótica.
Para las empresas, su interés está en aprovechar la inteligencia artificial incluso cuando los datos disponibles son limitados. Una consultoría de IA para empresas puede ayudar a evaluar la calidad de esos datos, seleccionar el enfoque adecuado y determinar si un sistema few-shot es viable para un proceso concreto.
A diferencia del entrenamiento convencional, que suele requerir numerosos ejemplos para identificar cada categoría, el few-shot learning busca generalizar a partir de pequeñas muestras. Esto no significa que el sistema aprenda de la nada: muchos métodos se apoyan en conocimientos adquiridos durante un entrenamiento previo o en técnicas que preparan al modelo para adaptarse con rapidez.
¿Cómo funciona el few-shot learning?
La idea consiste en presentar al sistema un conjunto reducido de ejemplos de una tarea nueva y comprobar si puede responder correctamente ante otros casos que nunca ha visto. Un modelo de clasificación de imágenes, por ejemplo, podría aprender a distinguir determinadas piezas industriales a partir de unas pocas fotografías etiquetadas de cada tipo.
Aprendizaje a partir de pocos ejemplos etiquetados
Un ejemplo etiquetado es un dato acompañado de su respuesta correcta, como una imagen de un componente marcada como «válido» o «defectuoso». En un escenario few-shot, cada clase dispone de pocas muestras. El modelo debe aprovechar las características que ya conoce y las relaciones entre las nuevas observaciones para decidir a qué grupo pertenece cada elemento.
La dificultad está en evitar que memorice los ejemplos. Si todas las fotografías de una pieza defectuosa muestran la misma iluminación, el sistema podría aprender a reconocer esa iluminación en lugar del defecto. Por eso la selección y diversidad de las muestras son tan importantes como su cantidad.
Clasificación N-way-K-shot: qué significa y cómo funciona
La expresión N-way-K-shot describe una configuración habitual de evaluación en few-shot learning. N indica el número de clases y K, el número de ejemplos etiquetados disponibles por clase.
En un problema 3-way-2-shot, el sistema debe distinguir tres categorías utilizando dos ejemplos de cada una. Esos seis ejemplos forman el conjunto de soporte. Después, recibe otras observaciones, llamadas conjunto de consulta, que debe clasificar. Este esquema permite evaluar si realmente ha generalizado a casos nuevos.
Ejemplo práctico de aprendizaje few-shot
Imagina una empresa que fabrica tornillos, arandelas y tuercas. Quiere clasificar fotografías de piezas que llegan a una cinta de revisión, pero solo dispone de cinco imágenes etiquetadas de cada categoría. Un sistema preparado para aprendizaje few-shot podría utilizar esas imágenes como referencia y tratar de identificar piezas adicionales.
No bastaría con probarlo sobre las mismas quince fotografías. Habría que evaluarlo con imágenes distintas, tomadas en varias condiciones, para saber si el reconocimiento funciona fuera de la pequeña muestra inicial. En producción, además, deberían medirse los errores y establecerse revisiones humanas cuando las predicciones no fueran suficientemente fiables.
Diferencias entre zero-shot, one-shot y few-shot learning
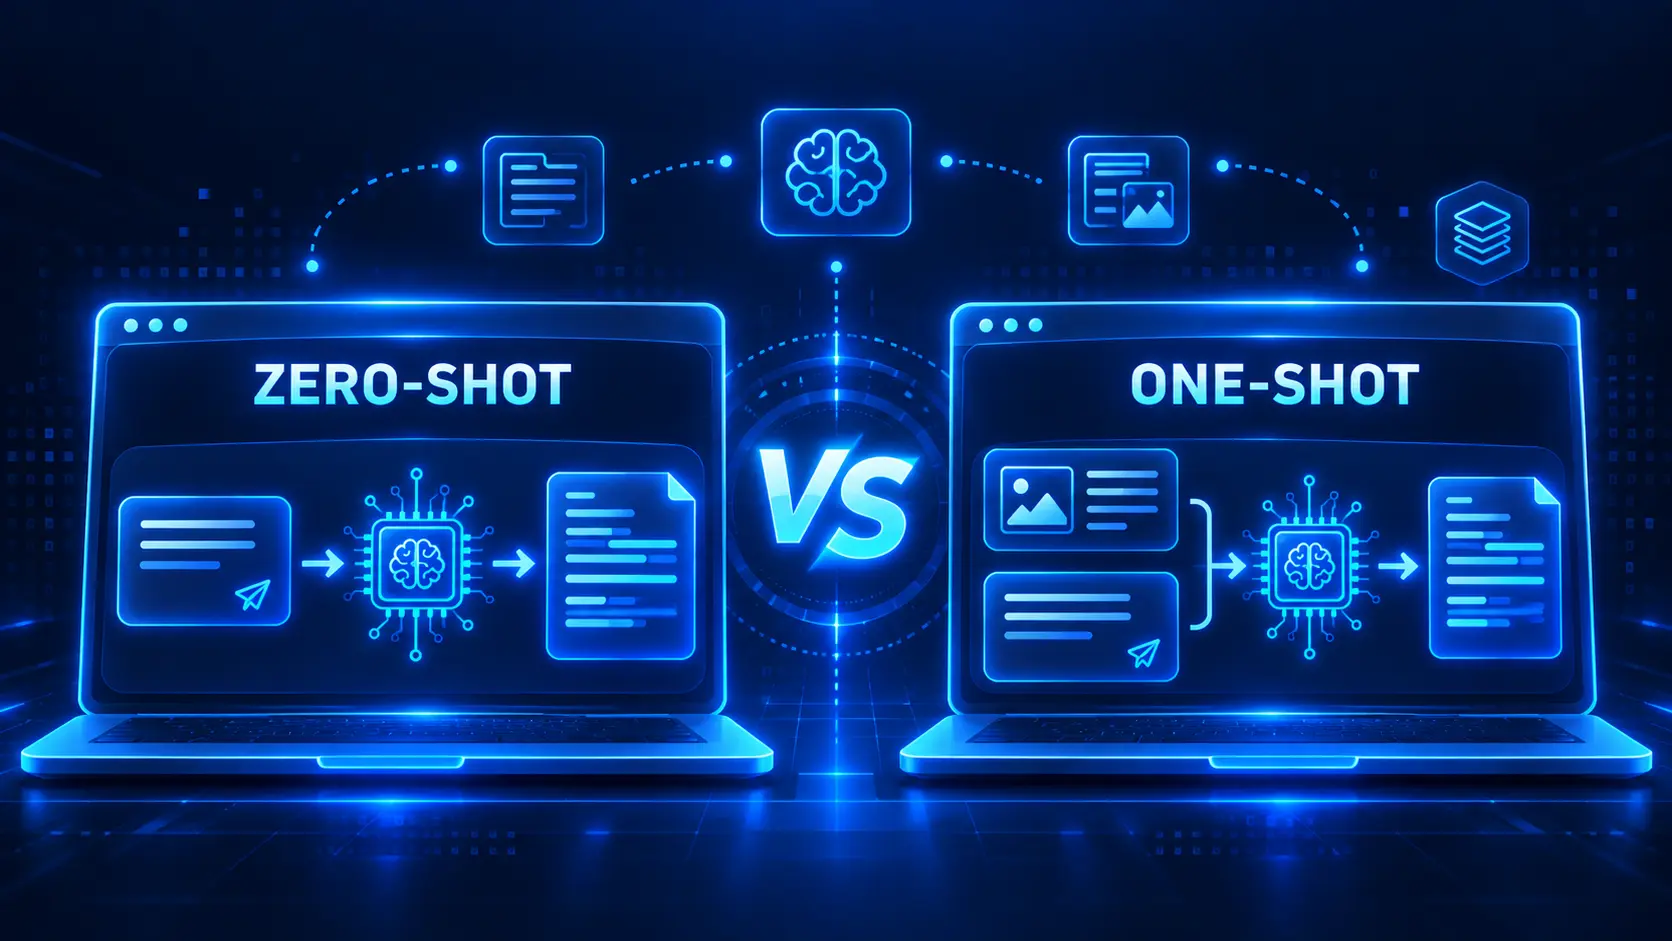
Los tres términos describen situaciones de aprendizaje con distinta disponibilidad de ejemplos de las nuevas clases. No implican que se utilice siempre un algoritmo distinto: el método concreto depende de la tarea y de cómo se haya preparado el modelo.
Zero-shot learning: aprendizaje sin ejemplos de la nueva clase.
En zero-shot learning, el modelo debe realizar una predicción sobre categorías para las que no dispone de ejemplos etiquetados específicos. Puede apoyarse en descripciones, relaciones semánticas o representaciones previamente aprendidas. Su éxito depende de la información transferible disponible y de la naturaleza de la tarea.
One-shot learning: aprendizaje con un único ejemplo.
El one-shot learning se considera habitualmente un caso especialmente exigente del aprendizaje con pocas muestras: se proporciona un solo ejemplo por clase. Es útil para estudiar situaciones de extrema escasez de datos, pero una muestra aislada puede no reflejar toda la variabilidad real.
Few-shot learning: aprendizaje con un conjunto reducido de ejemplos.
El few-shot learning trabaja con varios ejemplos por clase, aunque siguen siendo muy pocos en comparación con un conjunto de entrenamiento convencional. Contar con distintas muestras permite representar mejor las variaciones relevantes, pero no garantiza precisión por sí solo: influyen la calidad de los datos, la similitud con tareas previas y el algoritmo empleado.
Principales técnicas de few-shot learning
El few-shot learning no es un algoritmo único. Es un problema de aprendizaje que puede abordarse mediante diferentes técnicas, a menudo combinadas entre sí.
Transfer learning o aprendizaje por transferencia
El aprendizaje por transferencia consiste en adaptar a una tarea nueva un modelo que ya ha aprendido representaciones útiles durante un entrenamiento anterior. Por ejemplo, un sistema que reconoce formas y texturas en miles de imágenes puede necesitar menos muestras para distinguir nuevas clases de componentes similares.
La transferencia funciona mejor cuando la tarea original y la nueva comparten características relevantes. Si la nueva información es muy diferente, el conocimiento previo puede resultar insuficiente y la precisión disminuir.
Meta-learning o metaaprendizaje
El metaaprendizaje se describe a menudo como aprender a aprender. En lugar de especializarse únicamente en una tarea, el modelo se prepara mediante numerosas tareas de entrenamiento relacionadas para adaptarse con rapidez a problemas posteriores.
En clasificación few-shot, esto puede hacerse con episodios que presentan distintas clases, ejemplos de soporte y consultas. La meta es desarrollar representaciones o parámetros iniciales que permitan responder bien cuando aparecen clases nuevas y hay pocos ejemplos disponibles.
Aprendizaje basado en datos y generación de muestras
Cuando los datos son escasos, otra estrategia es ampliar el conjunto disponible mediante transformaciones o muestras sintéticas. En visión artificial, por ejemplo, se pueden variar de forma controlada el encuadre o la iluminación de imágenes existentes, siempre que esas modificaciones no alteren su etiqueta.
También pueden emplearse modelos generativos, como las redes generativas antagónicas (GAN), para crear muestras adicionales. Sin embargo, los datos sintéticos deben validarse: si reproducen errores o sesgos de las muestras originales, pueden perjudicar el aprendizaje en lugar de mejorarlo.
Algoritmos y modelos utilizados en few-shot learning
Entre los enfoques estudiados destacan los métodos basados en métricas, que comparan representaciones de los datos, y los basados en optimización, que buscan facilitar la adaptación de los parámetros del modelo.
Redes siamesas
Las redes siamesas procesan dos ejemplos mediante componentes que comparten parámetros y aprenden una representación útil para estimar si pertenecen a la misma categoría. Son especialmente conocidas por tareas de comparación, como verificar si dos imágenes muestran el mismo tipo de objeto.
En este método no se aprende únicamente una etiqueta a partir de una imagen aislada, sino una forma de comparar dos observaciones. Esa comparación puede ser útil cuando aparecen categorías nuevas y no se dispone de suficientes ejemplos para entrenar un clasificador completo. Su rendimiento, no obstante, depende de que las representaciones aprendidas sean capaces de distinguir semejanzas relevantes y no solo detalles superficiales.
Redes prototípicas
Las redes prototípicas calculan una representación característica o prototipo de cada clase a partir de sus ejemplos. Una nueva muestra se clasifica según su proximidad a los prototipos en el espacio de representación. Su funcionamiento resulta intuitivo cuando se dispone de pocas observaciones por categoría.
Por ejemplo, si una empresa necesita reconocer tres tipos de piezas y dispone de varias fotografías de cada una, el sistema puede resumir cada categoría en un prototipo y comparar con él las nuevas imágenes. Es un planteamiento relativamente directo, aunque se vuelve más exigente cuando una misma clase presenta grandes variaciones de apariencia o cuando las categorías se parecen mucho entre sí.
Redes de coincidencia y redes de relaciones
Las redes de coincidencia comparan la nueva muestra con los ejemplos disponibles mediante medidas de similitud y mecanismos de atención. Por su parte, las redes de relaciones aprenden una función para valorar la relación entre muestras, en lugar de depender únicamente de una distancia fijada de antemano.
Ambas familias buscan aprovechar los pocos ejemplos disponibles sin entrenar necesariamente un clasificador convencional desde cero para cada nueva categoría.
La diferencia práctica está en cómo se calcula esa semejanza: algunos sistemas utilizan funciones de atención para ponderar los ejemplos disponibles y otros aprenden explícitamente una puntuación de relación. En ambos casos, el reto es que esa valoración continúe siendo útil ante cambios de contexto, ruido en las muestras o categorías que no estaban presentes en el entrenamiento original.
Model-Agnostic Meta-Learning (MAML)
MAML es un método de metaaprendizaje basado en optimización. Durante el entrenamiento aprende un punto de partida de parámetros desde el que el modelo puede adaptarse a nuevas tareas con pocos pasos de actualización.
Su interés radica en la rapidez de adaptación, aunque el entrenamiento puede ser más exigente en cálculo y memoria que el de métodos más sencillos. Existen variantes que intentan reducir ese coste.
En términos prácticos, no pretende resolver de antemano cada problema futuro, sino aprender una inicialización que pueda ajustarse con rapidez cuando llegan los pocos datos de una tarea nueva. Esto lo convierte en un referente del metaaprendizaje, pero no implica que sea la mejor elección para cualquier proyecto: hay que valorar la complejidad de implementación, el coste computacional y el resultado de las pruebas frente a alternativas más sencillas.
Ventajas del aprendizaje few-shot
La principal ventaja es la posibilidad de desarrollar modelos útiles sin depender de grandes colecciones de datos etiquetados para cada tarea nueva. Esto puede abrir oportunidades en ámbitos donde etiquetar exige personal especializado o donde ciertos eventos apenas ocurren.
También facilita, en determinados escenarios, adaptar sistemas preentrenados a categorías nuevas, experimentar con prototipos y reducir el esfuerzo asociado a preparar datos. Por ejemplo, una empresa puede explorar la clasificación de incidencias poco frecuentes sin disponer desde el primer momento de miles de registros para cada tipo de problema.
No obstante, el ahorro de datos no equivale automáticamente a un ahorro de costes globales. Elegir modelos, preparar episodios de entrenamiento, realizar pruebas y supervisar resultados puede requerir recursos técnicos importantes.
Limitaciones y desafíos del few-shot learning
Riesgo de sobreajuste y dificultades de generalización.
Con tan pocos ejemplos, el modelo puede memorizar particularidades irrelevantes en lugar de aprender patrones que se mantengan en situaciones nuevas. El sobreajuste se manifiesta cuando ofrece buenos resultados sobre las muestras conocidas, pero falla con datos reales diferentes.
Calidad y representatividad de los datos.
Si los ejemplos presentan etiquetas erróneas, sesgos o escasa variedad, el problema se agrava. Es preferible disponer de pocas muestras bien seleccionadas y revisadas que acumular otras que no reflejan las condiciones de uso.
Complejidad de entrenamiento y recursos necesarios.
Algunos métodos exigen preentrenamiento, episodios de metaaprendizaje o arquitecturas especializadas. También resulta fundamental contar con un protocolo de evaluación que utilice clases y ejemplos adecuados para medir la generalización, sin mezclar inadvertidamente datos de entrenamiento y prueba.
Trabajar con pocas muestras permite abordar problemas que serían difíciles de resolver con un entrenamiento supervisado convencional, pero también aumenta la sensibilidad del sistema a la composición del conjunto de datos. Por eso, antes de evaluar un modelo few-shot, conviene definir en qué condiciones se utilizará, qué errores resultarían aceptables y cómo se comprobará su comportamiento cuando aparezcan datos diferentes a los empleados durante las pruebas. Estas precauciones son especialmente importantes cuando una predicción puede condicionar un proceso empresarial.
Aplicaciones y casos de uso del few-shot learning
Las aplicaciones del aprendizaje few-shot aparecen sobre todo cuando conseguir nuevos ejemplos etiquetados exige mucho trabajo o cuando las categorías cambian con frecuencia. El objetivo no suele ser sustituir de forma indiscriminada los modelos tradicionales, sino aprovechar sistemas previamente entrenados para afrontar tareas específicas con menos muestras. A continuación se presentan ámbitos donde se investiga o utiliza este enfoque, teniendo presente que el grado de madurez y los requisitos de validación varían notablemente de un sector a otro.
Reconocimiento de imágenes y visión artificial
En visión artificial, el few-shot learning se investiga para clasificar imágenes y detectar objetos cuando existen pocas fotografías etiquetadas de ciertas categorías. Puede resultar útil en inspección de calidad, donde determinadas anomalías son poco frecuentes.
Un ejemplo sería la identificación de defectos de fabricación que apenas aparecen en una línea de producción. En lugar de reunir miles de fotografías de cada anomalía, se puede evaluar si un modelo preentrenado reconoce patrones relevantes utilizando una muestra más pequeña. Para decidir si es viable, deberían probarse imágenes obtenidas con diferentes cámaras, posiciones, materiales e iluminaciones, y comprobar especialmente los defectos que el sistema deja sin detectar.
Procesamiento del lenguaje natural
En el procesamiento del lenguaje natural, estos enfoques permiten estudiar cómo adaptar modelos a nuevas clases de texto, intenciones o categorías de documentos cuando hay pocas anotaciones. Su utilidad depende de la tarea y del conocimiento previo disponible en el modelo.
Por ejemplo, una organización puede querer clasificar consultas sobre incidencias muy específicas para las que apenas conserva ejemplos históricos. Un enfoque de aprendizaje con pocas muestras podría aprovechar representaciones lingüísticas previamente adquiridas y adaptarlas a esas categorías. Aun así, deben revisarse las ambigüedades del lenguaje, la variación de vocabulario y la calidad de las etiquetas, ya que estos factores pueden afectar tanto como el número de documentos disponibles.
Diagnóstico médico y análisis de imágenes clínicas
En investigación médica, disponer de pocos ejemplos de una afección infrecuente puede dificultar el desarrollo de clasificadores. El aprendizaje few-shot se estudia para analizar patrones con muestras limitadas, aunque cualquier aplicación clínica necesita validación rigurosa, control de sesgos y supervisión especializada.
El interés de esta línea de trabajo se entiende especialmente en problemas con muestras escasas, como determinadas patologías poco frecuentes. Sin embargo, que un modelo alcance buenos resultados sobre un conjunto experimental reducido no demuestra que pueda utilizarse de forma segura en pacientes reales. Son necesarias evaluaciones externas, datos representativos de distintas poblaciones y protocolos clínicos que delimiten su función y las decisiones que deben seguir bajo responsabilidad profesional.
Detección de fraudes y anomalías
Los fraudes poco habituales y determinados incidentes presentan escasos casos etiquetados. El few-shot learning puede ayudar a investigar modelos que detecten clases nuevas o poco frecuentes, pero no sustituye la evaluación de falsos positivos, falsos negativos y cambios en los patrones de comportamiento.
La dificultad es que las conductas fraudulentas pueden evolucionar y los casos conocidos no siempre representan los que aparecerán después. Por eso interesa combinar la capacidad del modelo para reconocer patrones poco frecuentes con análisis de riesgo, seguimiento continuo y revisión humana de alertas. Además de la precisión global, deben medirse las consecuencias de investigar operaciones legítimas y de pasar por alto incidencias relevantes.
Robótica y sistemas inteligentes
En robótica, adaptar el reconocimiento de objetos o situaciones a entornos nuevos con pocas observaciones es una línea de investigación relevante. El desafío consiste en que esa adaptación sea suficientemente robusta cuando cambian las condiciones físicas.
Un robot que reconoce piezas en un entorno controlado puede encontrarse con objetos nuevos, variaciones de posición o condiciones de iluminación inesperadas. El aprendizaje con pocas muestras podría ayudar a ampliar su capacidad de reconocimiento sin reconstruir todo el sistema de entrenamiento. Aun así, el paso a entornos físicos exige comprobar la fiabilidad de la percepción y definir cómo actuará el robot cuando la información sea insuficiente o incierta.
Diferencias entre few-shot learning y few-shot prompting
Aunque sus nombres se parecen, few-shot learning y few-shot prompting no son exactamente lo mismo. El primero es un marco amplio de aprendizaje automático con pocos ejemplos, que puede implicar entrenamiento o adaptación de parámetros. El segundo es una técnica de elaboración de instrucciones: se muestran varios ejemplos dentro del prompt para orientar la respuesta de un modelo de lenguaje.
El prompting con ejemplos puede considerarse una forma de **aprendizaje en contexto** en modelos de lenguaje, pero conviene **no confundirlo con todas las metodologías de FSL**. Si quieres profundizar en cómo diseñar instrucciones con ejemplos, puedes consultar nuestro contenido específico sobre *few-shot prompting* cuando esté publicado.
¿Cómo pueden aprovechar las empresas el few-shot learning?
Para una organización, la pregunta no es únicamente si el few-shot learning funciona, sino si resuelve un problema concreto con el nivel de fiabilidad necesario. Antes de elegirlo, conviene analizar qué datos existen, cuánto cuesta etiquetarlos, cómo se medirá el rendimiento y qué consecuencias tienen los errores.
Adaptación de modelos de IA a tareas específicas
Una empresa puede partir de modelos preentrenados y estudiar su adaptación a una clasificación propia: tipologías de producto, incidencias o documentos de uso interno. El enfoque adecuado dependerá de la similitud entre los datos del modelo original y los de la nueva tarea.
Por ejemplo, una compañía que incorpora nuevos tipos de producto a su catálogo podría analizar si un modelo de visión previamente entrenado puede reconocerlos a partir de fotografías limitadas. Antes de implantarlo, tendría que evaluar si esos ejemplos representan las variaciones reales y si la tasa de error permite utilizar las predicciones en el trabajo diario. En ocasiones bastará con ajustar un sistema existente; en otras, será preferible recurrir a más datos o a una tecnología diferente.
Automatización inteligente con datos limitados
En procesos con pocos registros de ciertas excepciones, un enfoque few-shot puede ser una alternativa de investigación o desarrollo. Aun así, la automatización debe contemplar controles de calidad, supervisión humana y seguimiento del rendimiento, especialmente en decisiones sensibles.
Esta opción puede tener sentido cuando una incidencia poco frecuente exige una clasificación inicial para dirigirla al equipo correspondiente. Pero disponer de un modelo capaz de sugerir una categoría no equivale a tener un proceso completamente automatizado y fiable. Conviene introducir verificaciones, registrar los errores y reservar la intervención humana para los casos ambiguos o de mayor impacto, de modo que la tecnología ayude sin trasladar decisiones delicadas a un sistema insuficientemente evaluado.
Consultoría de inteligencia artificial para identificar oportunidades
En Process Control, el punto de partida es analizar el proceso de negocio y la información disponible antes de elegir una tecnología. A través de sus servicios de consultoría de IA para empresas, ayuda a estudiar oportunidades de automatización, integración con sistemas empresariales y desarrollo de soluciones ajustadas a las necesidades de cada organización.
La elección entre few-shot learning, otras técnicas de machine learning o soluciones de IA generativa debe responder a las características de los datos y al objetivo operativo, no solo a la popularidad de una tecnología. Si quieres estudiar un caso concreto, puedes contactar con Process Control.
En una fase inicial resulta más útil concretar el problema, revisar las muestras disponibles y fijar un criterio de éxito que seleccionar de inmediato una arquitectura determinada. También es importante comprobar si las herramientas actuales de la organización ya ofrecen una solución suficiente, porque no todos los problemas con pocos datos requieren un proyecto específico de few-shot learning.
La inteligencia artificial ofrece nuevas posibilidades para automatizar procesos y aprovechar mejor los datos empresariales. En este vídeo puedes descubrir cómo se integra con los sistemas ERP y cómo ambas tecnologías pueden contribuir a mejorar la eficiencia de una organización.
Preguntas frecuentes sobre few-shot learning
El aprendizaje con pocas muestras plantea dudas habituales sobre el número de ejemplos necesarios, los algoritmos disponibles y su diferencia respecto a otras técnicas de inteligencia artificial. También conviene distinguir las posibilidades demostradas en entornos de investigación de los resultados que puede esperar una empresa en sus propios procesos. Las siguientes respuestas reúnen las cuestiones fundamentales para entender cuándo tiene sentido estudiar este enfoque y qué condiciones deberían comprobarse antes de trasladarlo a una aplicación real.
¿Qué significa few-shot learning en inteligencia artificial?
Few-shot learning significa aprendizaje con pocos ejemplos. Se refiere a enfoques de aprendizaje automático que buscan reconocer nuevas clases o resolver tareas utilizando una cantidad reducida de muestras etiquetadas.
A diferencia de un aprendizaje supervisado convencional que puede necesitar numerosas observaciones de cada clase, el objetivo es aprovechar conocimiento previo para adaptarse a categorías nuevas con muestras limitadas. No debe confundirse con aprender sin ninguna información anterior: las representaciones adquiridas por el modelo suelen desempeñar un papel decisivo en el resultado.
¿Cuántos ejemplos necesita el few-shot learning?
No existe una cantidad universal. En estudios de clasificación se suelen comparar configuraciones de uno, cinco u otros pocos ejemplos por clase, pero la cifra adecuada depende del problema, la calidad de los datos y el método utilizado.
Las configuraciones de investigación suelen describirse con expresiones como 5-way-1-shot o 5-way-5-shot, que indican cuántas categorías y ejemplos por categoría se utilizan. En una aplicación empresarial, sin embargo, la cantidad debe decidirse a partir de pruebas con datos representativos, incluyendo casos difíciles y muestras independientes para comprobar la generalización.
¿Es lo mismo few-shot learning que few-shot prompting?
No. El aprendizaje few-shot engloba distintos métodos de machine learning con pocas muestras. El few-shot prompting consiste en incluir ejemplos en una instrucción para guiar las respuestas de un modelo, sin necesidad de actualizar sus parámetros.
En el prompting, las demostraciones se incorporan a la instrucción de un modelo de lenguaje y orientan su respuesta dentro de ese contexto. En el aprendizaje few-shot pueden utilizarse otros modelos, métodos de adaptación y procesos de entrenamiento. La distinción es importante para valorar recursos, costes y expectativas antes de elegir una solución.
¿Qué algoritmos se utilizan en el aprendizaje few-shot?
Entre las alternativas estudiadas se encuentran redes siamesas, redes prototípicas, redes de coincidencia, redes de relaciones y métodos como MAML. También se recurre al aprendizaje por transferencia y a estrategias de aumento de datos.
No existe un algoritmo universalmente superior: la elección depende del tipo de dato, las clases, el conocimiento previo del modelo y el coste de adaptación. Las redes basadas en similitud pueden ser adecuadas para ciertos problemas de clasificación, mientras que los enfoques de metaaprendizaje buscan optimizar cómo se adapta el sistema a tareas nuevas.
¿En qué sectores se utiliza el few-shot learning?
Se investiga y aplica en ámbitos como visión artificial, procesamiento del lenguaje, robótica, salud, industria y detección de anomalías. Su idoneidad debe evaluarse caso por caso mediante pruebas con datos representativos.
En industria puede estudiarse para reconocer defectos poco frecuentes; en gestión documental, para clasificar categorías con pocos registros; y en investigación sanitaria, para analizar conjuntos limitados de imágenes. En todos estos ámbitos es esencial distinguir una prueba prometedora de una solución lista para producción, evaluando calidad, seguridad y supervisión según el contexto.