Los modelos de lenguaje de gran tamaño, conocidos habitualmente como LLM por las siglas Large Language Models, son sistemas de inteligencia artificial entrenados con enormes volúmenes de datos para aprender patrones del lenguaje y generar respuestas coherentes a partir de una instrucción. Su desarrollo ha impulsado buena parte de las aplicaciones de IA generativa que utilizamos actualmente, desde asistentes conversacionales hasta herramientas de programación, análisis documental o automatización.
En una empresa, los LLM pueden utilizarse para mucho más que generar texto. Cuando se integran correctamente con datos, aplicaciones y procesos internos, pueden resumir documentación, analizar información, apoyar al equipo comercial, generar código o formar parte de agentes capaces de ejecutar tareas. Una Consultoría IA para empresas permite identificar qué casos de uso tienen sentido, cómo integrar estos modelos con los sistemas existentes y qué controles deben establecerse para utilizarlos de forma segura.
A lo largo de este artículo veremos qué es exactamente un LLM, cómo funciona, cómo se entrena, qué son los tokens y los parámetros, cuáles son sus principales aplicaciones y qué diferencias existen frente a conceptos como IA generativa, RAG, modelos fundacionales, agentes de IA o inteligencia artificial general.
¿Qué es un LLM o modelo de lenguaje de gran tamaño?

Un LLM es un modelo de deep learning entrenado con grandes cantidades de información para reconocer patrones y relaciones dentro del lenguaje. En muchos casos utiliza arquitecturas de tipo Transformer, que permiten analizar las relaciones entre diferentes partes de una secuencia y utilizar ese contexto para generar una respuesta.
Aunque desde fuera pueda parecer que el modelo comprende una pregunta del mismo modo que una persona, su funcionamiento se basa en cálculos estadísticos. Durante la generación va estimando qué token es más probable que aparezca a continuación en función de la información disponible y de los patrones que aprendió durante el entrenamiento.
Qué significa LLM
LLM son las siglas de Large Language Model, que en castellano suele traducirse como modelo de lenguaje de gran tamaño. El término hace referencia tanto a la escala del modelo como al enorme volumen de datos y recursos utilizados durante su entrenamiento.
Por qué se llaman modelos de lenguaje de gran tamaño
El adjetivo “gran tamaño” suele estar relacionado con el número de parámetros del modelo, la cantidad de información utilizada para entrenarlo y los recursos computacionales necesarios. Muchos LLM han trabajado con miles de millones de parámetros y grandes colecciones de texto, código y otros contenidos.
Qué diferencia a un LLM de otros modelos de IA
La principal diferencia está en su orientación hacia el lenguaje y en su versatilidad. Un modelo tradicional puede entrenarse para una tarea muy específica, mientras que un LLM de propósito general puede reutilizarse para resumir documentos, responder preguntas, traducir, generar código o clasificar información sin necesitar un modelo completamente distinto para cada función.
¿Cómo funcionan los modelos de lenguaje de gran tamaño?
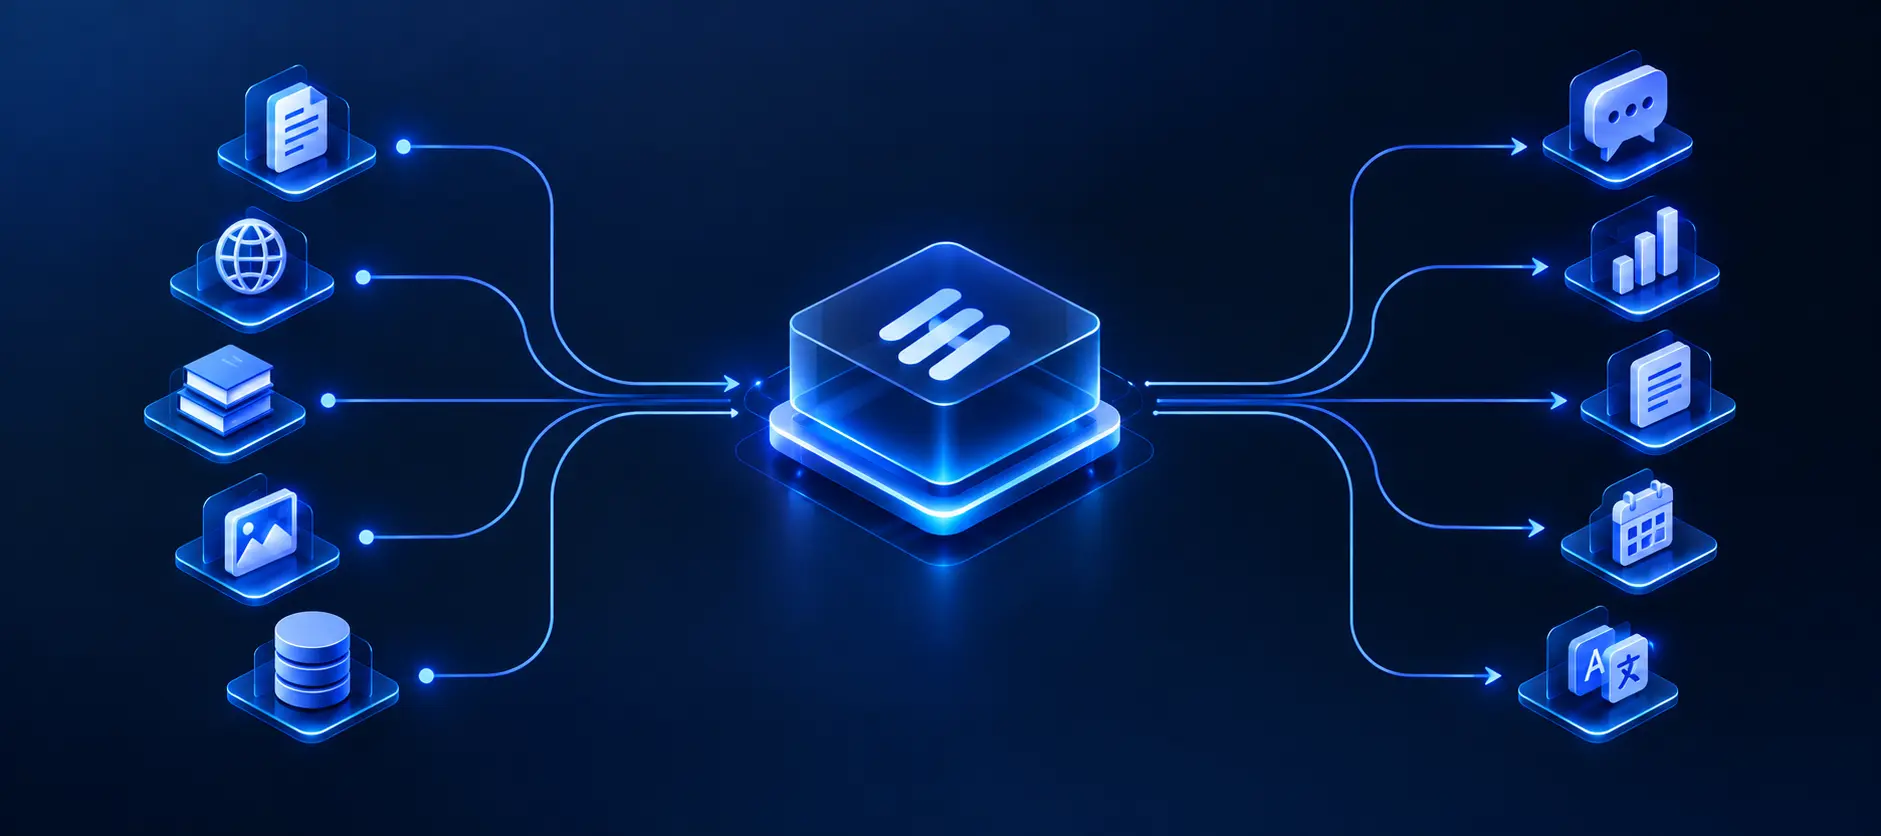
El funcionamiento de un LLM combina varias etapas. El texto se transforma primero en unidades procesables por la máquina, después se representa numéricamente y finalmente atraviesa diferentes capas de una red neuronal que calculan relaciones entre los elementos del contexto.
Tokenización del texto
Antes de que el modelo pueda procesar una frase, esta se divide en tokens. Un token puede representar una palabra completa, una parte de una palabra, un signo de puntuación o incluso otros fragmentos según el sistema utilizado. Esta división permite convertir el lenguaje en unidades que el modelo puede manejar matemáticamente.
Embeddings y representación numérica
Los tokens se convierten en representaciones numéricas llamadas embeddings. Estos vectores permiten representar relaciones semánticas, de manera que términos utilizados en contextos similares pueden terminar ocupando posiciones cercanas dentro del espacio matemático del modelo.
Arquitectura Transformer
Buena parte de los LLM modernos se han construido sobre la arquitectura Transformer. Su aparición supuso un cambio importante porque permitió procesar secuencias de manera más eficiente y capturar relaciones entre elementos que pueden encontrarse muy alejados dentro de un texto.
Mecanismo de atención y autoatención
La autoatención permite que el modelo determine qué partes del contexto son más relevantes para interpretar cada token. En lugar de procesar únicamente las palabras de forma aislada, puede ponderar las relaciones entre ellas y construir representaciones cada vez más ricas a medida que la información atraviesa las diferentes capas de la red.
Predicción del siguiente token
Cuando un LLM genera una respuesta, calcula cuál es el siguiente token más probable teniendo en cuenta los tokens anteriores y los patrones aprendidos durante el entrenamiento. El proceso se repite una y otra vez hasta formar una respuesta completa.
¿Cómo se entrena un LLM?
El entrenamiento de un modelo de lenguaje de gran tamaño requiere grandes conjuntos de datos y una cantidad considerable de capacidad computacional. El proceso suele comenzar con una fase de preentrenamiento general y puede continuar con diferentes técnicas de adaptación para mejorar su utilidad en contextos concretos.
Preentrenamiento con grandes volúmenes de datos
Durante el preentrenamiento, el modelo procesa grandes cantidades de texto procedentes de diferentes fuentes. El objetivo es aprender patrones del lenguaje, relaciones entre conceptos, estructuras gramaticales y otras regularidades que posteriormente podrá utilizar para realizar distintas tareas.
Aprendizaje autosupervisado
Muchos LLM utilizan aprendizaje autosupervisado, lo que permite entrenar el sistema con enormes cantidades de información sin necesidad de etiquetar manualmente cada ejemplo. El propio contenido proporciona las señales necesarias para aprender a predecir elementos faltantes o el siguiente token.
Ajuste de parámetros
Durante el entrenamiento, el modelo compara sus predicciones con el resultado esperado y modifica progresivamente sus parámetros para reducir el error. Este proceso se repite millones de veces hasta que las representaciones internas permiten generar resultados más coherentes.
Fine-tuning o ajuste fino
Una vez preentrenado, un modelo puede adaptarse con información más específica mediante fine-tuning. Este proceso permite orientar un modelo general hacia un sector, estilo de respuesta o tarea concreta sin tener que entrenarlo completamente desde cero.
RLHF y feedback humano
El aprendizaje por refuerzo a partir de feedback humano, conocido como RLHF, utiliza valoraciones humanas para orientar las respuestas del modelo hacia resultados más útiles, seguros o alineados con determinadas preferencias.
Ajuste de instrucciones
El ajuste de instrucciones busca mejorar la capacidad del modelo para interpretar solicitudes humanas y responder de acuerdo con la intención del usuario. Esto resulta especialmente importante en asistentes conversacionales y aplicaciones empresariales.
¿Qué son los parámetros de un LLM?
Los parámetros son valores internos que el modelo ajusta durante el entrenamiento. Determinan cómo se transforma la información a medida que atraviesa las diferentes capas de la red neuronal y forman parte de lo que el modelo ha aprendido.
Cómo influyen los parámetros en el modelo
Un mayor número de parámetros proporciona al modelo mayor capacidad para representar relaciones complejas, aunque también aumenta los recursos necesarios para entrenarlo y ejecutarlo. Los parámetros por sí solos no determinan la calidad final, porque también influyen la arquitectura, los datos de entrenamiento y las técnicas utilizadas durante el ajuste.
¿Más parámetros significa siempre un mejor LLM?
No necesariamente. Un modelo más pequeño y bien optimizado puede superar a otro mayor en determinadas tareas. Además, en entornos empresariales puede ser preferible utilizar modelos más eficientes cuando ofrecen suficiente calidad con menor coste, latencia o consumo de recursos.
¿Qué es la ventana de contexto de un LLM?
La ventana de contexto determina cuánta información puede tener en cuenta un modelo durante una interacción. Se mide habitualmente en tokens e incluye tanto las instrucciones y documentación proporcionadas como la conversación o el contenido generado dentro de ese mismo contexto.
Qué son los tokens de contexto
Los tokens son las unidades en las que se divide el contenido antes de ser procesado. Cuantos más tokens admita una ventana de contexto, mayor cantidad de información puede recibir simultáneamente el modelo.
Por qué importa la longitud de contexto
Una ventana amplia facilita tareas como revisar documentación extensa, analizar grandes bases de código o mantener conversaciones prolongadas. Sin embargo, disponer de más contexto no garantiza automáticamente que toda la información se utilice con la misma precisión.
Qué ocurre cuando se supera la ventana de contexto
Cuando una conversación o conjunto de documentos supera el límite admitido, parte de la información debe quedar fuera del contexto o gestionarse mediante otras técnicas. En aplicaciones empresariales esto puede resolverse con recuperación de información, memoria externa o sistemas que seleccionan únicamente los datos relevantes para cada consulta.
¿Para qué sirven los modelos de lenguaje de gran tamaño?
Una de las principales características de los LLM es su capacidad para reutilizarse en tareas muy diferentes. Un mismo modelo puede responder preguntas, transformar contenido, clasificar información o servir como base para aplicaciones más complejas.
Generación de texto
Los LLM pueden redactar correos electrónicos, informes, documentación, contenidos o propuestas a partir de instrucciones en lenguaje natural. La calidad depende del contexto, del modelo elegido y de las instrucciones proporcionadas.
Resumen de documentos
Pueden procesar grandes cantidades de contenido y extraer los elementos principales, lo que resulta útil para contratos, informes, documentación técnica o comunicaciones empresariales.
Traducción de idiomas
Los modelos multilingües pueden traducir contenido entre diferentes idiomas y adaptar tono o terminología según las instrucciones del usuario.
Generación y revisión de código
Los LLM también pueden generar código, explicar fragmentos existentes, detectar errores o ayudar a transformar instrucciones expresadas en lenguaje natural en consultas y scripts.
Clasificación y análisis de textos
Pueden clasificar documentos, detectar temáticas, analizar opiniones o identificar elementos relevantes dentro de grandes volúmenes de información no estructurada.
Asistentes de inteligencia artificial
Los asistentes conversacionales utilizan LLM para interpretar las preguntas del usuario y generar respuestas. Cuando se conectan con documentación, datos o herramientas externas pueden evolucionar hacia aplicaciones mucho más útiles para el trabajo diario.
Razonamiento y resolución de problemas
Determinados modelos pueden abordar problemas de varios pasos, analizar diferentes alternativas y generar explicaciones estructuradas. Estas capacidades pueden utilizarse como parte de flujos más complejos, aunque los resultados deben evaluarse porque los modelos pueden cometer errores.
Ejemplos de LLM conocidos
El ecosistema de modelos de lenguaje ha crecido rápidamente y existen diferentes familias desarrolladas por empresas y organizaciones tecnológicas. Algunos ejemplos conocidos son los siguientes.
GPT
GPT es una familia de modelos generativos basada en Transformers que ha sido utilizada como base de diferentes aplicaciones conversacionales y herramientas de inteligencia artificial.
Claude
Claude es una familia de modelos desarrollada por Anthropic y utilizada en diferentes aplicaciones de análisis, programación, generación de contenido y trabajo con grandes volúmenes de contexto.
Gemini
Gemini es la familia de modelos de Google orientada a aplicaciones de inteligencia artificial multimodal, capaz de trabajar con diferentes tipos de información según la versión y el entorno utilizado.
Llama
Llama es una familia de modelos desarrollada por Meta que ha ganado relevancia dentro del ecosistema de modelos abiertos y aplicaciones personalizadas.
Granite
Granite es una familia de modelos desarrollada por IBM y orientada a diferentes casos de uso empresariales y de inteligencia artificial.
¿Cuál es la diferencia entre un LLM y la IA generativa?
LLM e IA generativa están relacionados, pero no significan exactamente lo mismo. Un LLM es un tipo concreto de modelo orientado principalmente al lenguaje, mientras que la inteligencia artificial generativa engloba tecnologías capaces de crear diferentes tipos de contenido.
LLM como tipo de modelo
Los LLM están diseñados para procesar secuencias y trabajar especialmente con lenguaje, aunque determinados modelos modernos también forman parte de sistemas multimodales.
IA generativa como categoría más amplia
La IA generativa incluye sistemas capaces de generar texto, imágenes, audio, vídeo, código y otros contenidos. Por tanto, los LLM forman parte de este ecosistema, pero no abarcan todas las tecnologías generativas.
No toda IA generativa utiliza exclusivamente LLM
Un generador de imágenes, por ejemplo, puede utilizar arquitecturas diferentes a las empleadas tradicionalmente en modelos de lenguaje. Por eso es más preciso entender los LLM como una categoría concreta dentro de un ecosistema de IA generativa mucho más amplio.
¿Cuál es la diferencia entre un LLM y un modelo fundacional?
Un modelo fundacional es un modelo entrenado a gran escala que puede adaptarse posteriormente a diferentes aplicaciones. Muchos LLM encajan dentro de esta categoría, pero el concepto de modelo fundacional es más amplio y también puede incluir modelos orientados a otras modalidades.
Qué es un foundation model
Un foundation model se entrena sobre grandes cantidades de información con el objetivo de desarrollar capacidades generales que después puedan reutilizarse en diferentes tareas mediante prompts, fine-tuning u otras técnicas de adaptación.
Cuándo un LLM puede considerarse modelo fundacional
Cuando un LLM ha sido entrenado con un objetivo general y puede utilizarse como base para diferentes aplicaciones, puede considerarse también un modelo fundacional. La diferencia está principalmente en que “LLM” describe su relación con el lenguaje, mientras que “foundation model” describe su función como base reutilizable.
¿Cuál es la diferencia entre un LLM y la inteligencia artificial general?
Que un modelo pueda realizar muchas tareas diferentes no significa que haya alcanzado inteligencia artificial general. Un LLM sigue siendo un sistema diseñado y entrenado dentro de una arquitectura concreta, con limitaciones de conocimiento, razonamiento y adaptación.
Un LLM no es una AGI
La inteligencia artificial general describe un sistema hipotético capaz de aprender y desenvolverse de forma general entre diferentes tareas intelectuales. Los modelos actuales pueden presentar capacidades muy amplias, pero no existe consenso para considerarlos AGI.
Capacidades generalistas frente a inteligencia general
Un LLM puede resolver múltiples tipos de consultas porque ha aprendido patrones muy amplios, pero eso no implica disponer de una comprensión general comparable a la humana. Si quieres profundizar en esta diferencia, puedes consultar nuestro artículo sobre ejemplos de inteligencia artificial general o AGI.
¿Qué relación existe entre LLM y agentes de IA?
Un LLM por sí solo genera respuestas utilizando el contexto disponible. Cuando se combina con memoria, herramientas, APIs y lógica de ejecución puede convertirse en una pieza central dentro de un sistema agéntico capaz de realizar acciones.
El LLM como motor de razonamiento
Dentro de un agente, el modelo puede interpretar el objetivo del usuario, analizar el contexto y decidir qué pasos debe seguir. Sin embargo, necesita herramientas externas cuando la tarea requiere consultar información o actuar sobre otros sistemas.
Memoria, herramientas y sistemas externos
Un agente puede incorporar memoria para conservar información, herramientas para realizar operaciones y conectores para acceder a servicios externos. Estas piezas amplían las capacidades del modelo más allá de la generación de texto.
Del LLM al agente de IA
Cuando el modelo puede seleccionar herramientas, encadenar acciones y comprobar los resultados, el sistema adquiere un comportamiento más autónomo. Puedes profundizar en este concepto en nuestro artículo sobre qué es la IA agéntica y cómo funciona en empresas.
¿Cómo se conecta un LLM con información empresarial?
Una de las claves para aprovechar los LLM en una empresa es proporcionarles contexto actualizado. Existen diferentes estrategias para hacerlo, desde simples instrucciones hasta arquitecturas capaces de consultar sistemas internos en tiempo real.
Prompt engineering
La forma más directa consiste en proporcionar al modelo instrucciones y contexto dentro del propio prompt. Es útil para tareas concretas, pero está limitada por la ventana de contexto y por la necesidad de introducir manualmente la información.
RAG
La generación aumentada por recuperación, o RAG, permite buscar información relevante en una fuente externa y proporcionarla al modelo antes de generar la respuesta. De esta forma es posible trabajar con documentación actualizada sin volver a entrenar el LLM.
APIs
Las APIs permiten que una aplicación consulte información o ejecute operaciones sobre otros sistemas. Un agente puede utilizarlas para trabajar con ERP, CRM, plataformas de correo electrónico o cualquier servicio que exponga una interfaz adecuada.
Model Context Protocol
MCP busca estandarizar la conexión entre aplicaciones de inteligencia artificial y herramientas externas. En lugar de desarrollar una lógica distinta para cada integración, proporciona una interfaz común para exponer recursos y capacidades al modelo.
Puedes ampliar esta parte en nuestro artículo sobre qué es el MCP o Model Context Protocol.
Bases de datos y sistemas empresariales
La conexión con bases de datos, ERP o CRM permite proporcionar a los modelos información real sobre clientes, inventario, pedidos, proyectos o cualquier otro dato operativo. El acceso debe diseñarse con permisos y controles adecuados para evitar que el modelo consulte o modifique información fuera de su ámbito.
La integración de la inteligencia artificial con los sistemas ERP abre nuevas posibilidades para automatizar procesos, consultar información empresarial y mejorar la toma de decisiones. En el siguiente vídeo exploramos cómo se relacionan ambas tecnologías y qué oportunidades ofrecen a las empresas.
Ventajas de los modelos de lenguaje de gran tamaño
Flexibilidad para múltiples tareas
Un mismo modelo puede utilizarse para diferentes tipos de tareas sin desarrollar una solución completamente distinta para cada una, lo que permite acelerar la creación de aplicaciones de IA.
Interacción mediante lenguaje natural
Los usuarios pueden interactuar con aplicaciones complejas utilizando preguntas y órdenes expresadas de forma natural, reduciendo la necesidad de conocer interfaces o lenguajes técnicos.
Automatización de tareas
Integrados con herramientas y procesos, los LLM pueden automatizar tareas de análisis, clasificación, generación de contenido o apoyo administrativo.
Acceso más sencillo al conocimiento
Un LLM conectado a documentación empresarial puede facilitar que los empleados consulten grandes volúmenes de información mediante preguntas en lenguaje natural.
Capacidad de adaptación a diferentes sectores
Los modelos pueden personalizarse mediante instrucciones, contexto o fine-tuning para trabajar con terminología y necesidades específicas de distintos sectores.
Limitaciones y riesgos de los LLM
Alucinaciones
Un LLM puede generar información incorrecta con una redacción aparentemente convincente. Por este motivo, las aplicaciones empresariales deben incorporar validaciones y fuentes fiables cuando la precisión sea importante.
Sesgos de los datos de entrenamiento
Los patrones aprendidos dependen de la información utilizada durante el entrenamiento. Si existen sesgos o desequilibrios en esos datos, pueden reflejarse en las respuestas del modelo.
Información desactualizada
Un modelo aislado no conoce automáticamente los cambios producidos después de su entrenamiento. Para trabajar con información reciente necesita acceso a fuentes externas mediante RAG, APIs, MCP u otros mecanismos.
Coste computacional
Entrenar y ejecutar modelos grandes puede requerir una cantidad considerable de capacidad de cálculo. En un proyecto empresarial es importante equilibrar rendimiento, coste y latencia según el caso de uso.
Privacidad y seguridad
La información enviada a un modelo puede contener datos confidenciales. Las empresas deben decidir qué datos pueden procesarse, dónde se alojan los modelos y qué controles existen sobre el acceso y almacenamiento de información.
Dependencia del contexto y de las instrucciones
La calidad de la respuesta puede variar considerablemente según la claridad de la solicitud y la información proporcionada. Diseñar correctamente las instrucciones y el contexto sigue siendo una parte importante de cualquier aplicación basada en LLM.
Cómo se utilizan los LLM en empresas
Los modelos de lenguaje pueden aplicarse en diferentes áreas de una organización, especialmente cuando se combinan con información interna y sistemas empresariales.
Atención al cliente
Un asistente puede responder preguntas, clasificar consultas y recuperar documentación relevante, reduciendo parte de la carga repetitiva del equipo de soporte.
Automatización administrativa
Los LLM pueden ayudar a procesar correos electrónicos, resumir documentos, clasificar información o preparar contenido para diferentes procesos internos.
Análisis de documentación
Contratos, manuales, informes y documentación técnica pueden convertirse en fuentes consultables mediante lenguaje natural cuando se integran con sistemas adecuados de recuperación.
Generación de informes
Un modelo conectado a datos empresariales puede transformar información estructurada en explicaciones, resúmenes y borradores de informes adaptados a diferentes usuarios.
Desarrollo de software
Los equipos técnicos pueden utilizar LLM como apoyo para programación, documentación, revisión de código y generación de pruebas, siempre dentro de procesos de validación adecuados.
Integración con ERP y CRM
Cuando el modelo puede consultar datos del ERP o CRM, las respuestas dejan de ser genéricas y pueden incorporar contexto real sobre clientes, pedidos, proyectos o actividad comercial.
Agentes de inteligencia artificial
Los LLM pueden actuar como motor dentro de agentes capaces de consultar sistemas, utilizar herramientas y completar tareas de varios pasos. El valor aparece cuando esa autonomía está orientada a procesos concretos y cuenta con los controles necesarios.
Cómo implementar LLM en una empresa de forma útil
La utilidad de un LLM no depende únicamente de elegir el modelo más avanzado. Para generar impacto empresarial es necesario conectar la tecnología con un proceso concreto, disponer de información adecuada y definir cómo se va a medir el resultado.
Identificar casos de uso
El primer paso consiste en localizar tareas repetitivas, procesos intensivos en documentación o actividades donde el lenguaje sea una parte importante del trabajo. No todos los procesos necesitan un LLM y no todos aportan el mismo retorno.
Preparar los datos
Los resultados dependen de la calidad de la información disponible. Antes de integrar IA conviene revisar dónde están los datos, si son accesibles, qué permisos existen y si representan correctamente el proceso que se quiere automatizar.
Elegir el modelo adecuado
El modelo debe elegirse en función del caso de uso, coste, latencia, privacidad, idioma, ventana de contexto y calidad necesaria. Utilizar el modelo más grande disponible no es siempre la decisión más eficiente.
Integrarlo con los sistemas internos
ERP, CRM, documentación, correo electrónico y bases de datos contienen el contexto que permite que la IA sea útil para una empresa concreta. APIs, RAG y MCP son algunas de las tecnologías que pueden utilizarse para realizar estas conexiones.
Definir seguridad y permisos
Cada aplicación debe acceder únicamente a la información necesaria. También conviene separar las capacidades de consulta de aquellas que permiten modificar sistemas y establecer revisiones humanas cuando la acción tenga impacto relevante.
Medir resultados y costes
El proyecto debe evaluarse mediante indicadores relacionados con el proceso, como reducción de tiempos, errores, carga administrativa o capacidad de atención. También es necesario medir el consumo del modelo para comprobar que la arquitectura es sostenible.
En Process Control analizamos los procesos de cada empresa antes de definir qué modelo o tecnología utilizar. Nuestro servicio de consultoría e implementación de Inteligencia Artificial para empresas permite identificar casos de uso, integrar LLM con sistemas empresariales y desarrollar soluciones adaptadas a la operativa real de la organización.
Preguntas frecuentes sobre modelos de lenguaje de gran tamaño
¿Qué significa LLM?
LLM significa Large Language Model, o modelo de lenguaje de gran tamaño. Se refiere a modelos de inteligencia artificial entrenados con grandes cantidades de datos para trabajar con lenguaje y realizar diferentes tareas.
¿ChatGPT es un LLM?
ChatGPT es una aplicación conversacional que utiliza modelos de lenguaje como parte de su funcionamiento. Por tanto, conviene diferenciar entre el modelo y la interfaz o producto con el que interactúa el usuario.
¿Cuál es la diferencia entre un LLM y ChatGPT?
Un LLM es el modelo que procesa y genera lenguaje. ChatGPT es una aplicación construida alrededor de modelos y otros componentes que permiten ofrecer una experiencia conversacional al usuario.
¿Gemini es un LLM?
Gemini es una familia de modelos de inteligencia artificial desarrollada por Google. Dependiendo de la versión, integra capacidades de lenguaje y otras modalidades dentro de sistemas más amplios.
¿Claude es un LLM?
Claude es una familia de modelos de inteligencia artificial desarrollada por Anthropic y utilizada en aplicaciones conversacionales, análisis y otras tareas relacionadas con lenguaje.
¿Un LLM entiende realmente el lenguaje?
Los LLM aprenden relaciones y patrones estadísticos muy complejos que les permiten trabajar con el lenguaje de manera convincente. Sin embargo, afirmar que comprenden exactamente igual que una persona sería una simplificación excesiva.
¿Cómo aprende un LLM?
Durante el entrenamiento procesa enormes cantidades de ejemplos y ajusta sus parámetros para mejorar sus predicciones. Posteriormente puede adaptarse mediante técnicas como fine-tuning, aprendizaje por refuerzo o ajuste de instrucciones.
¿Qué son los tokens en un LLM?
Los tokens son las unidades en las que se divide el contenido para que el modelo pueda procesarlo. Pueden representar palabras completas, partes de palabras o signos, dependiendo del sistema de tokenización utilizado.
¿Qué es la ventana de contexto?
Es la cantidad máxima de tokens que un modelo puede tener disponibles simultáneamente para interpretar una solicitud y generar su respuesta.
¿Qué diferencia hay entre LLM y RAG?
El LLM es el modelo que genera la respuesta. RAG es una técnica que recupera información externa relevante y la proporciona al modelo como contexto antes de generar esa respuesta.
¿Los LLM pueden conectarse con datos de una empresa?
Sí. Pueden conectarse con documentación, bases de datos, ERP, CRM y otros sistemas mediante RAG, APIs, MCP u otras integraciones. El acceso debe configurarse con los permisos y controles adecuados.
¿Los LLM son inteligencia artificial general?
No. Los LLM actuales pueden realizar una gran variedad de tareas, pero eso no significa que hayan alcanzado inteligencia artificial general. AGI sigue siendo un concepto distinto asociado a una capacidad de aprendizaje y adaptación mucho más general.