Los componentes de un agente de IA son las piezas de software y los mecanismos de control que permiten a un sistema recibir información, decidir qué hacer y ejecutar acciones para alcanzar un objetivo. En su forma más sencilla, un agente basado en modelos de lenguaje combina un modelo que interpreta la situación, unas instrucciones que delimitan su comportamiento y herramientas con las que puede consultar datos o actuar sobre otros sistemas. A partir de esa base pueden añadirse memoria, planificación avanzada, mecanismos de validación y coordinación con otros agentes.
La diferencia frente a un asistente que se limita a responder preguntas no consiste únicamente en que un agente utilice un modelo más avanzado. Lo que cambia es la capacidad de intervenir en un proceso: consultar el estado de un pedido, actualizar una oportunidad comercial, clasificar una incidencia o proponer una acción que deba aprobar una persona. Para conseguirlo, los componentes deben comunicarse correctamente y respetar las reglas del negocio. Un agente que razona bien pero accede a datos equivocados, o que dispone de herramientas sin límites de permisos, puede generar más problemas que soluciones.
Entender esta arquitectura ayuda a las empresas a definir proyectos de automatización realistas. A través de la consultoría de IA para empresas, es posible analizar qué procesos necesitan capacidad de decisión, qué fuentes de datos deben conectarse y qué controles conviene establecer antes de poner un sistema en producción. En esta guía explicamos los componentes principales, cómo trabajan juntos y qué debe tener en cuenta una organización para utilizarlos con seguridad.
¿Qué es un agente de IA y cómo funciona su arquitectura?
Un agente de inteligencia artificial es una aplicación diseñada para perseguir un objetivo utilizando información del entorno y, cuando corresponde, herramientas externas. Puede recibir una petición en lenguaje natural, interpretar su intención, seleccionar entre varias acciones y comprobar si el resultado cumple lo solicitado. En los agentes modernos, un modelo de lenguaje grande o LLM suele intervenir en las decisiones, pero la aplicación completa incluye mucha más lógica que el modelo por separado. La definición operativa importa: no todo chatbot es un agente y no toda automatización requiere autonomía.
Pensemos en una consulta comercial sencilla: «¿Tenemos existencias de este producto y cuándo podríamos entregarlo?». Un chatbot desconectado de los sistemas internos solo puede ofrecer información genérica. Un agente con acceso autorizado al inventario y a las reglas logísticas puede identificar el producto, consultar el stock disponible, revisar los plazos vigentes y preparar una respuesta contextualizada. Si la tarea incluye reservar mercancía o modificar una fecha comprometida, se necesitarán permisos adicionales y, en determinados casos, una aprobación humana. La diferencia no está en el tono de la respuesta, sino en las operaciones que el sistema puede realizar y verificar.
La arquitectura suele describirse mediante un ciclo de percepción, razonamiento, acción y observación. El agente recibe una entrada, la interpreta en relación con su objetivo, decide si debe llamar a una herramienta y utiliza la respuesta obtenida para continuar o detenerse. Este proceso puede repetirse varias veces. El patrón conocido como ReAct combina razonamiento y acciones, pero es una forma de organizar ese ciclo, no una obligación técnica de todos los agentes. Hay soluciones que funcionan con reglas más definidas, sistemas que delegan tareas entre agentes y casos en los que un flujo tradicional resulta más apropiado.
Por eso conviene distinguir entre la arquitectura mínima y las capacidades complementarias. La base de un agente con LLM está formada por modelo, instrucciones y herramientas, acompañados de un mecanismo de ejecución que conecta las decisiones con los resultados. La planificación, la memoria persistente, la comunicación multiagente y el aprendizaje pueden ampliar sus posibilidades, pero su presencia depende del caso de uso. La elección correcta empieza por el proceso empresarial, no por acumular componentes tecnológicos.
¿Cuáles son los principales componentes de un agente de IA?
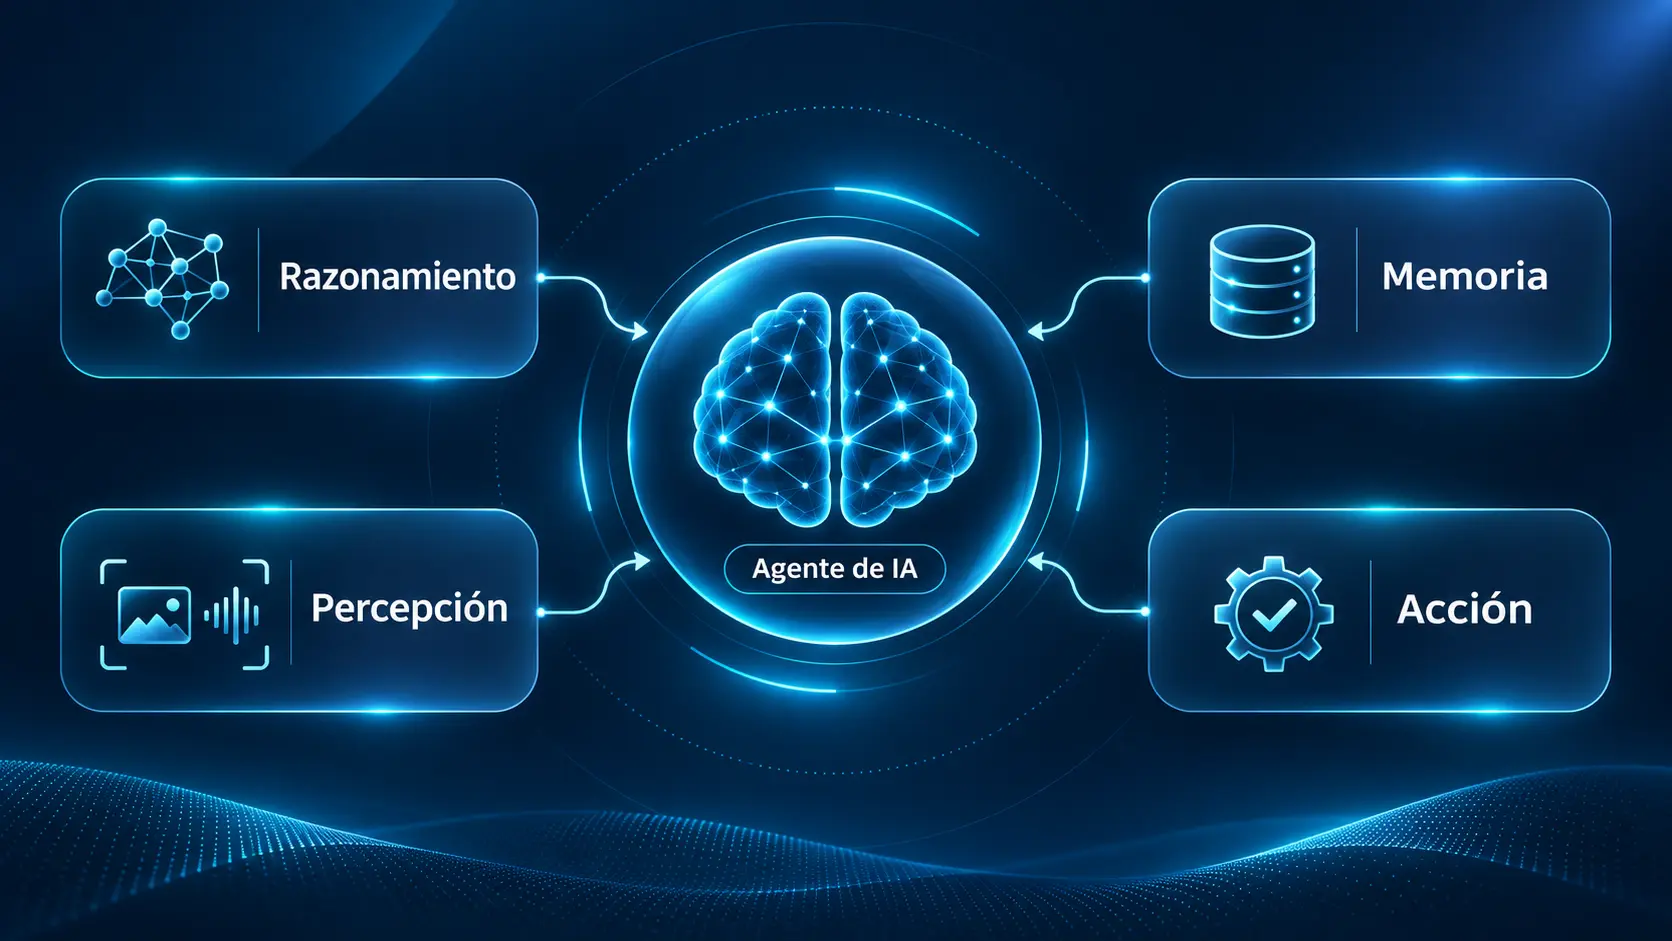
Aunque diferentes fabricantes utilizan taxonomías distintas, los componentes de un agente de IA pueden organizarse según la función que cumplen dentro del sistema. Algunos permiten comprender información, otros determinan qué acción conviene realizar y otros ejecutan esa acción o conservan el contexto. Esta clasificación resulta más útil que buscar una cifra universal de cinco, siete u ocho elementos, porque la arquitectura cambia entre un agente de atención al cliente, uno de análisis documental y otro conectado a maquinaria industrial.
La siguiente tabla sintetiza las funciones habituales. Debe leerse como un mapa de diseño: no significa que todos los agentes necesiten una base de datos vectorial, un módulo separado de planificación o un sistema de aprendizaje permanente. El requisito esencial es que cada capacidad añadida resuelva una necesidad concreta y pueda evaluarse en condiciones reales.
Percepción y procesamiento de información
La percepción es la capacidad de transformar entradas del entorno en información que el agente pueda utilizar. En una aplicación empresarial, esas entradas pueden proceder de una conversación, un correo electrónico, un documento PDF, un formulario, un evento del ERP o una llamada a una API. También pueden incluir imágenes, voz o señales de sensores, siempre que existan componentes adecuados para procesarlas. El objetivo no es acumular datos, sino identificar qué información está relacionada con la tarea, de dónde procede y qué grado de confianza merece.
Por ejemplo, un agente que gestiona incidencias recibe un mensaje indicando que una factura no coincide con la mercancía entregada. Antes de tomar decisiones, necesita reconocer el cliente, el documento afectado y la discrepancia descrita. Si hay un archivo adjunto, puede requerirse OCR o extracción documental; si el mensaje llega desde una cuenta no autenticada, el sistema deberá comprobar la identidad antes de consultar datos sensibles. Así, la percepción incluye tanto interpretar el contenido como respetar los límites de acceso que condicionan su uso.
La calidad de esta fase repercute en todo el proceso. Un número de referencia mal extraído puede llevar al agente a consultar otro pedido, mientras que una instrucción maliciosa escondida en un documento puede intentar modificar su comportamiento. Por ello conviene validar campos, distinguir las instrucciones del usuario de los datos recuperados y registrar el origen de las entradas relevantes. Una buena arquitectura no presupone que todo texto recibido sea fiable ni que la información más reciente sea necesariamente la correcta.
Motor de razonamiento y planificación de tareas
El motor de razonamiento interpreta el objetivo y selecciona la siguiente acción en función del contexto disponible. En muchos agentes se apoya en un LLM, aunque determinadas decisiones pueden resolverse mediante reglas tradicionales. El modelo permite trabajar con peticiones formuladas de distintas maneras y con situaciones que no se han descrito exhaustivamente en un árbol de condiciones; sin embargo, su respuesta sigue siendo probabilística y puede cometer errores. Las comprobaciones decisivas deben apoyarse en fuentes de datos y controles externos cuando el impacto de una equivocación sea significativo.
Las instrucciones del agente, frecuentemente recogidas en mensajes de sistema o configuraciones de ejecución, determinan su papel, sus límites y las condiciones para utilizar cada herramienta. No basta con decirle que «sea útil»: hay que especificar qué información puede consultar, qué operaciones tiene prohibidas, qué datos necesita antes de ejecutar una acción y cuándo debe pedir ayuda a una persona. La documentación de procedimientos internos puede servir como punto de partida para formular estas reglas, siempre que se traduzca en instrucciones claras y verificables.
La planificación permite dividir una petición en pasos relacionados. Si un cliente solicita modificar un pedido, el agente podría comprobar la identidad, recuperar los datos, verificar la disponibilidad, calcular las consecuencias económicas y solicitar confirmación antes de aplicar cambios. En otras ocasiones bastará con una única consulta. La planificación puede estar integrada en el razonamiento del modelo, representarse como un flujo predefinido o combinar ambas opciones. No todas las tareas justifican un plan dinámico: cuanto más determinista sea el proceso, mayor sentido tiene conservar reglas fijas para las operaciones críticas.
Memoria y gestión del contexto
La memoria reúne mecanismos que permiten al agente mantener o recuperar información necesaria para completar una tarea. Conviene diferenciar la información disponible en la ejecución actual de los datos almacenados para futuras interacciones. La memoria de trabajo puede incluir el objetivo, el historial reciente, los resultados de herramientas y el estado de los pasos pendientes. La ventana de contexto del modelo limita la cantidad de información que puede utilizar simultáneamente, pero no equivale por sí sola a una memoria permanente.
Cuando un proceso dura varias sesiones, la aplicación puede conservar determinados datos en una base de datos: identificadores de casos, preferencias autorizadas, decisiones aprobadas o un resumen del estado anterior. También puede disponer de una base documental que recupera fragmentos relevantes mediante técnicas de búsqueda y RAG. Estos mecanismos ayudan a proporcionar continuidad, pero no implican que el modelo se reentrene ni que aprenda automáticamente de cada conversación. En términos prácticos, recuperar conocimiento almacenado y modificar los parámetros del modelo son operaciones diferentes.
En empresas, la memoria exige criterios de gobierno del dato. No toda información debe conservarse, y menos aún datos personales o documentos confidenciales sin una finalidad y una política de acceso claras. Es recomendable definir tiempos de retención, permisos de lectura, mecanismos de corrección y reglas para eliminar información obsoleta. Si un agente conserva un precio antiguo y lo combina con una tarifa actual, puede producir una respuesta aparentemente razonable pero comercialmente incorrecta. La trazabilidad de la información recuperada resulta tan importante como su disponibilidad.
Herramientas, ejecución de acciones y comunicación
Las herramientas convierten las decisiones del agente en operaciones comprobables. Pueden ser funciones internas, consultas a bases de datos, API de aplicaciones empresariales, motores de búsqueda o servicios que realizan cálculos y transformaciones. En un entorno con ERP y CRM, una herramienta puede leer existencias, otra recuperar el estado de una factura y otra crear una actividad comercial. El modelo no debe disponer de acceso indiscriminado al sistema: la aplicación intermediaria ejecuta llamadas definidas, comprueba parámetros y aplica la autorización correspondiente.
Es fundamental separar las herramientas de lectura de las que escriben o modifican información. Consultar el estado de un pedido presenta un riesgo distinto al de cancelar una venta, autorizar un descuento o ejecutar una transferencia. Para acciones sensibles, la arquitectura debe exigir confirmación, limitar cantidades, registrar quién inició la operación y permitir su revisión posterior. Un agente tampoco debería inventar que una herramienta ha tenido éxito: debe interpretar la respuesta real de la API, gestionar fallos y comunicar con precisión si la acción se completó, quedó pendiente o no pudo ejecutarse.
La comunicación permite presentar resultados a usuarios, pedir información adicional, escalar incidencias o intercambiar mensajes con otros agentes. En sistemas multiagente se añaden reglas para repartir responsabilidades y conservar un estado compartido sin duplicar tareas. Sin embargo, utilizar varios agentes no mejora automáticamente el resultado; también introduce transferencias de contexto, latencia y nuevas posibilidades de error. Para muchos procesos, un único agente con herramientas bien documentadas y un mecanismo de supervisión humano ofrece una arquitectura más sencilla de mantener.
¿Cómo trabajan juntos los componentes de un agente de IA?
El valor de una arquitectura agéntica no reside en sus piezas por separado, sino en la coordinación entre ellas. Un modelo puede comprender perfectamente una consulta, pero no resolverla si carece de acceso a la fuente adecuada. Una integración técnica puede funcionar sin errores y, aun así, ejecutar una operación que contradiga una política interna. Por eso el diseño debe contemplar tanto la circulación de información como los puntos donde se valida una decisión y se interrumpe el proceso si aparecen datos incompletos o riesgos relevantes.
Imaginemos un agente que recibe la reclamación «Mi pedido aparece entregado, pero no ha llegado». La percepción identifica la incidencia y extrae la referencia proporcionada. El motor de razonamiento determina que necesita consultar el ERP y, si existe, el sistema logístico. La herramienta de lectura devuelve el estado del envío, la fecha del último evento y el transportista. El agente observa los datos, detecta si existe una contradicción y decide si puede explicar lo sucedido o si debe crear un ticket para que lo revise el equipo de atención al cliente.
En una secuencia bien diseñada, cada operación produce una observación que alimenta el siguiente paso. Si el ERP señala «entregado» y la agencia de transporte registra «incidencia abierta», el agente no debe escoger arbitrariamente una versión; puede comunicar la discrepancia, abrir una investigación y evitar prometer una fecha que no consta en ningún sistema. Si la tarea exige compensación económica, una política puede impedir que el agente apruebe el abono por sí solo. De esta forma, la autonomía se aplica a las tareas repetitivas y la supervisión humana se reserva para las decisiones de mayor impacto.
El ciclo ReAct: razonamiento, acción y observación
El patrón ReAct describe una forma de interacción iterativa entre el razonamiento y el uso de herramientas. Ante un objetivo, el agente selecciona una acción disponible, recibe una observación del entorno y continúa hasta obtener información suficiente, completar la operación o alcanzar una condición de salida. La observación no es una confirmación automática de éxito: puede ser un error de autenticación, una respuesta vacía, un dato inconsistente o una señal de que la solicitud debe pasar a otra persona.
Aplicado a una gestión de pedidos, el ciclo podría consistir en consultar un número de referencia, comprobar que el cliente tiene permisos para acceder a él, recuperar los movimientos logísticos y generar una respuesta basada en los resultados. Si falta un identificador, la siguiente acción debería ser pedirlo; si se excede el número permitido de intentos, detener la ejecución. Definir condiciones de parada es tan importante como definir herramientas, porque evita bucles, llamadas repetidas y costes innecesarios.
Este planteamiento permite entender por qué la observabilidad forma parte del diseño operativo. Cada llamada relevante debe dejar registros suficientes para reconstruir qué herramienta se utilizó, qué resultado devolvió y qué decisión se adoptó a continuación, sin registrar más datos personales de los necesarios. Los indicadores de evaluación pueden medir resoluciones correctas, derivaciones adecuadas, errores de herramientas, tiempo de respuesta y coste por tarea completada. Un agente útil no es el que realiza más pasos, sino el que alcanza el resultado autorizado con una calidad repetible.
Memoria, aprendizaje y adaptación en los agentes inteligentes
Los conceptos de memoria y aprendizaje suelen mezclarse cuando se habla de inteligencia artificial, pero describen capacidades diferentes. Un agente puede conservar el estado de una tarea, consultar un historial de operaciones o recuperar un procedimiento actualizado sin modificar el modelo que utiliza. También puede funcionar sin memoria entre sesiones si su objetivo consiste en resolver peticiones independientes, como validar un formato documental o clasificar una solicitud puntual. Por ello no es correcto considerar la memoria persistente un requisito universal de todos los agentes.
La memoria de corto plazo se relaciona con el contexto operativo de la ejecución: instrucciones, mensajes, observaciones y resultados intermedios. Cuando ese conjunto crece, la aplicación puede resumir información, conservar únicamente los datos útiles o almacenar el estado fuera del modelo para recuperarlo más tarde. Es importante no confundir una ventana de contexto extensa con recuerdo indefinido. Incluso cuando un modelo admite mucha información, el sistema debe decidir qué es pertinente, qué puede compartirse y cuándo un dato ha dejado de ser válido.
La memoria a largo plazo suele organizarse en sistemas externos, como bases de datos transaccionales o repositorios documentales. Una base vectorial puede facilitar la búsqueda semántica de políticas de soporte, manuales o documentación técnica, aunque no sustituye la necesidad de verificar vigencia y permisos. En una aplicación conectada a una base de conocimiento corporativa, el agente debería recuperar el procedimiento aplicable a la incidencia, citar o identificar su origen y evitar utilizar versiones anteriores cuando el sistema ya dispone de una nueva instrucción aprobada.
El aprendizaje, en sentido estricto, implica cambios en el comportamiento del sistema a partir de experiencias o evaluaciones. Puede realizarse mejorando instrucciones, actualizando herramientas, corrigiendo documentos, ajustando reglas o entrenando un modelo mediante procedimientos específicos. No existe aprendizaje automático garantizado por el simple hecho de guardar conversaciones. Si se desea que un agente mejore con el uso, hay que diseñar una recogida de feedback, seleccionar métricas, revisar errores y controlar los cambios antes de aplicarlos en producción. Esto reduce el riesgo de que una respuesta equivocada se convierta en una supuesta norma para futuras interacciones.
La adaptación también tiene límites. Un agente puede reaccionar a un cambio de stock o una actualización del CRM porque consulta datos actuales, no necesariamente porque haya aprendido un patrón nuevo. La diferencia es esencial a la hora de valorar capacidades de proveedores y presupuestos: integrar fuentes de información, construir memoria persistente y entrenar modelos requieren trabajos y controles distintos. Para ampliar la perspectiva, el artículo de Process Control sobre IA agéntica y casos de uso empresariales ayuda a contextualizar estas capacidades dentro de procesos más amplios.
Aplicaciones de los componentes de agentes de IA en las empresas
Los agentes resultan especialmente interesantes en procesos que combinan información dispersa, decisiones repetitivas y acciones sobre aplicaciones existentes. Su valor no debería medirse por la cantidad de mensajes que generan, sino por el trabajo que ayudan a completar con menor carga manual y con controles adecuados. La elección de los componentes cambia según la operación: un asistente documental necesita recuperar conocimiento fiable, mientras que un agente de operaciones puede requerir una conexión transaccional con el ERP y mecanismos estrictos de aprobación.
En un departamento comercial, por ejemplo, el agente puede recibir una petición de seguimiento, consultar oportunidades del CRM y proponer actividades pendientes. La percepción interpreta qué cliente o cuenta interesa; la memoria de trabajo conserva las condiciones de la consulta; las herramientas leen la información autorizada; el modelo ayuda a priorizar; y la aplicación registra la actividad únicamente si dispone del permiso adecuado. En un departamento financiero, una arquitectura parecida puede ayudar a cotejar facturas, albaranes y pedidos, pero cualquier modificación contable requiere controles adicionales sobre consistencia, trazabilidad y segregación de funciones.
Agentes conectados a ERP, CRM y herramientas empresariales
La conexión con ERP y CRM es uno de los puntos donde mejor se aprecia la diferencia entre generar texto y ejecutar procesos. Si un empleado pregunta «¿Qué pedidos del cliente siguen pendientes?», el agente debe convertir la solicitud en una consulta concreta, seleccionar la cuenta correcta y recuperar información en tiempo real o con una fecha de actualización conocida. El modelo interpreta la pregunta, pero el ERP sigue siendo la fuente de referencia para los estados comerciales, las existencias o los documentos financieros. De este modo se reduce el riesgo de que una respuesta se apoye en conocimientos generales o datos desactualizados.
Cuando la arquitectura permite escribir en aplicaciones, conviene separar operaciones en distintos niveles de autorización. Un agente podría crear un borrador de presupuesto sin aprobación, pero necesitar confirmación antes de enviarlo al cliente; podría sugerir un ajuste de inventario, pero no aplicarlo hasta superar controles de negocio. Esta separación facilita incorporar IA a procedimientos existentes sin convertir cada petición en una acción irreversible. En entornos Odoo, resulta pertinente revisar las características y limitaciones de los servidores MCP de Odoo 20, sin asumir que MCP elimina por sí solo las exigencias de permisos o validación.
El diseño también debe prever cómo se gestionan los errores de integración. Una API puede devolver un timeout, un campo vacío o un mensaje ambiguo. Si el agente informa de que una operación se ha completado sin una respuesta positiva del sistema, se produce una falsa confirmación. Por ello es recomendable comprobar los identificadores de transacción, registrar los cambios reales y utilizar operaciones idempotentes cuando sea posible. En los flujos más sensibles, una persona debe poder revisar el estado y retomar el proceso desde un punto conocido.
Para profundizar en esta conexión entre la inteligencia artificial y los sistemas de gestión empresarial, el siguiente vídeo muestra cómo la IA puede integrarse con los ERP y ampliar sus capacidades, facilitando la automatización de procesos, el acceso a la información y la toma de decisiones en las empresas.
Atención al cliente, automatización documental y procesos internos
En atención al cliente, los componentes de un agente de IA pueden trabajar juntos para clasificar solicitudes, consultar información y generar respuestas respaldadas por datos. Un agente de soporte puede identificar el motivo de una incidencia, buscar un artículo de ayuda, comprobar el historial del ticket y recomendar la siguiente actuación. Sin embargo, la utilidad depende de las reglas de escalado: si el caso incluye una reclamación delicada, una información contradictoria o un pedido con implicaciones económicas, debe existir una transición clara al equipo humano.
La automatización documental es otro caso especialmente práctico. Un agente puede recibir facturas y albaranes, extraer campos mediante herramientas de lectura documental, comparar importes y detectar diferencias antes de registrar resultados en un sistema. La interpretación de documentos exige validaciones concretas para cifras, fechas y referencias. Si el OCR confunde un número de factura, el sistema debe marcarlo como incierto en lugar de completar el proceso silenciosamente. La supervisión no impide automatizar: permite concentrar la revisión en los documentos que realmente presentan anomalías.
En procesos internos, los agentes pueden apoyar tareas como preparar informes, localizar procedimientos, clasificar solicitudes de empleados o coordinar acciones de mantenimiento. La complejidad aumenta cuando distintos departamentos intervienen en el mismo flujo. En ese escenario puede resultar útil orquestar agentes especializados, pero solo después de verificar que un agente único no cubre la necesidad. También es importante distinguir un agente de IA de un asistente convencional, ya que una interfaz conversacional no garantiza capacidad de actuación sobre los sistemas de la empresa.
¿Cómo diseñar e implementar un agente de IA fiable?
El primer paso para construir un agente no es elegir el modelo más potente, sino definir una tarea concreta con principio, fin y resultados observables. Una empresa puede empezar por un proceso de bajo riesgo, como recuperar información de manuales internos o preparar borradores de seguimiento comercial. Esto permite comprobar si la IA realmente mejora la operación antes de concederle permisos de escritura o ampliar su autonomía. También facilita crear un conjunto de casos de prueba que represente situaciones habituales, datos incompletos y errores que el sistema debe gestionar.
Después conviene identificar qué sistemas contienen la información necesaria, quién puede acceder a ella y cuáles son las acciones permitidas. No es lo mismo consultar una ficha de cliente que modificar un contrato. Las herramientas deben describirse con parámetros claros, validar las entradas y devolver respuestas estructuradas que el agente pueda interpretar. El modelo debe contar con instrucciones precisas, pero esas instrucciones no sustituyen los controles de seguridad aplicados por el propio software. Una prohibición escrita en un prompt no equivale a impedir técnicamente una llamada no autorizada.
La elección del modelo afecta a la calidad, la latencia y el coste de cada operación. Una tarea de clasificación simple puede funcionar con un modelo de menor tamaño, mientras que la interpretación de solicitudes ambiguas puede necesitar más capacidad. Lo conveniente es medir resultados con ejemplos propios y comparar alternativas. El coste no depende únicamente del precio del modelo: intervienen el número de llamadas, la longitud del contexto, las consultas a sistemas externos, la repetición de operaciones fallidas y la infraestructura de monitorización. Por ello conviene evaluar el coste por tarea correctamente resuelta, no solo el coste por mensaje.
La fase de pruebas debe incluir tanto casos de éxito como situaciones donde el agente debe detenerse. Entre ellos pueden figurar pedidos inexistentes, datos contradictorios, intentos de acceder a otra cuenta, documentos con instrucciones maliciosas o herramientas que responden con errores. Los controles de salida deben impedir confirmar operaciones que no se han realizado, y las acciones sensibles tienen que exigir aprobación cuando corresponda. Es recomendable dejar constancia de qué versión del sistema generó una respuesta, qué herramientas utilizó y por qué una intervención humana fue necesaria, respetando los requisitos de protección de datos.
Una vez validado el prototipo, la organización necesita monitorización, responsables claros y un procedimiento de mejora. Los indicadores pueden medir precisión de respuesta, éxito de las integraciones, casos escalados correctamente, tiempo de resolución, satisfacción y consumo de recursos. Un buen despliegue no termina cuando el agente funciona en una demostración: requiere mantenimiento de credenciales, actualización de procesos y revisión de cambios en aplicaciones conectadas. La supervisión continua permite ajustar las capacidades sin comprometer la trazabilidad del sistema.
Principales errores y limitaciones de la arquitectura de agentes de IA
Los agentes pueden fallar por motivos distintos a los errores de un chatbot tradicional. Además de generar respuestas inexactas, pueden seleccionar una herramienta equivocada, interpretar mal una respuesta estructurada o repetir una acción que ya se había ejecutado. Cuanta mayor autonomía se conceda, más importante resulta controlar las consecuencias. Un sistema que prepara borradores presenta un perfil de riesgo diferente al de otro que modifica contratos o gestiona devoluciones, aunque ambos utilicen el mismo modelo de lenguaje.
Entre los problemas más habituales se encuentran las alucinaciones, la pérdida de contexto, el uso de información desactualizada y los fallos de coordinación. En sistemas con varios agentes se añaden transferencias incompletas, duplicidades y dificultad para atribuir responsabilidades. Otra amenaza relevante es la inyección de instrucciones, cuando un texto de origen externo intenta alterar las reglas que debe seguir el sistema. La protección exige distinguir datos de instrucciones, limitar privilegios, validar herramientas y evitar que una respuesta generada tenga autoridad para ejecutar operaciones críticas sin verificaciones independientes.
La observabilidad y la gestión de errores deben diseñarse desde el principio. Si una integración deja de estar disponible, el agente necesita saber si puede reintentar la consulta, utilizar otra fuente o detenerse y comunicar la incidencia. Repetir automáticamente una orden de pago o una actualización sin comprobar el estado podría duplicar transacciones. Por este motivo es útil establecer identificadores únicos, límites de intentos, registros de auditoría y mecanismos de compensación o reversión donde la operación lo permita. También deben existir políticas explícitas para datos personales, credenciales y documentación confidencial.
Finalmente, hay un riesgo de diseño menos visible: utilizar agentes donde no hacen falta. Si un proceso consiste en trasladar un dato conocido de un campo a otro siguiendo reglas fijas, la automatización convencional puede resultar más predecible y barata. Los agentes tienen sentido cuando deben interpretar información variable y seleccionar acciones dentro de unos límites. La arquitectura adecuada no es la más compleja, sino la que resuelve el problema con calidad medible, permisos proporcionados y una carga de mantenimiento asumible.
Preguntas frecuentes sobre los componentes de un agente de IA
Comprender la arquitectura de los agentes requiere separar conceptos que a menudo aparecen juntos en explicaciones simplificadas: el modelo que interpreta, las herramientas que ejecutan acciones, la memoria que conserva información y los controles que determinan qué operaciones están permitidas. Estas preguntas ayudan a aclarar qué elementos resultan esenciales, cuáles dependen del caso de uso y cómo valorar una solución antes de conectarla a los procesos de una empresa. También permiten distinguir las capacidades demostrables de las promesas genéricas de autonomía o aprendizaje permanente.
¿Cuáles son los componentes básicos de un agente de IA?
En un agente basado en LLM, los elementos fundamentales son el modelo, las instrucciones y las herramientas, coordinados por una lógica de ejecución. El modelo interpreta la solicitud y ayuda a decidir; las instrucciones delimitan sus objetivos y restricciones; y las herramientas permiten acceder a datos o actuar en sistemas externos. Muchas arquitecturas añaden percepción, memoria, planificación, comunicación y supervisión como capacidades específicas. La cantidad de módulos no determina por sí sola la calidad: importa que cumplan una función necesaria y estén correctamente conectados.
¿Qué función cumple un LLM dentro de un agente de IA?
El LLM suele actuar como motor de interpretación y selección de acciones. Puede convertir una solicitud expresada en lenguaje natural en una decisión sobre qué herramienta consultar, qué información adicional solicitar o cómo presentar los resultados. Sin embargo, el modelo no sustituye al ERP, al CRM ni a los controles de autorización. Para consultar o modificar datos reales necesita herramientas y una aplicación que ejecute sus llamadas. Su fiabilidad debe evaluarse junto con la calidad de las fuentes, la claridad de las instrucciones y las validaciones del sistema.
¿Todos los agentes de IA necesitan memoria?
No. Un agente que resuelve tareas independientes puede operar con el contexto de cada ejecución sin conservar información entre sesiones. La memoria persistente resulta útil cuando se necesita continuidad, como en un expediente que se trabaja durante varios días, pero exige políticas de almacenamiento, seguridad y actualización. Además, memoria y aprendizaje no son equivalentes: guardar una conversación en una base de datos no reentrena el modelo. El sistema podrá utilizarla después solo si existe un mecanismo diseñado para recuperarla cuando sea pertinente.
¿Qué diferencia existe entre un agente de IA y un chatbot?
Un chatbot puede limitarse a generar respuestas, mientras que un agente está diseñado para decidir y ejecutar pasos orientados a un objetivo utilizando herramientas y observando los resultados. Por ejemplo, un chatbot puede explicar cómo consultar una factura; un agente autorizado puede localizarla en el ERP y preparar una incidencia relacionada. No obstante, un chatbot también puede incorporar herramientas y capacidades agénticas, por lo que la diferencia práctica se encuentra en su arquitectura y en el grado de actuación real, no en el aspecto de su interfaz.