El fine-tuning es el proceso de adaptar un modelo de inteligencia artificial previamente entrenado para que funcione mejor en una tarea, dominio o caso de uso concreto. En lugar de entrenar un modelo desde cero, se aprovechan los conocimientos que ya ha adquirido durante el preentrenamiento y se continúa entrenándolo con un conjunto de datos más pequeño y específico.
Esta técnica es especialmente relevante en los modelos fundacionales y modelos de lenguaje de gran tamaño o LLM, porque permite especializar capacidades generales sin asumir de nuevo el enorme coste computacional del entrenamiento inicial. Una empresa puede utilizar fine-tuning para adaptar el tono de un asistente, mejorar su comportamiento ante determinadas instrucciones, especializarlo en un sector o enseñarle a responder siguiendo un formato concreto.
Sin embargo, no todos los proyectos de inteligencia artificial necesitan fine-tuning. En determinadas situaciones puede ser suficiente utilizar prompting, RAG u otras técnicas. Una Consultoría IA para empresas permite analizar el proceso, los datos disponibles y el comportamiento esperado para determinar qué método de adaptación tiene más sentido.
¿Qué es el fine-tuning en inteligencia artificial?
En machine learning, el fine-tuning consiste en continuar el entrenamiento de un modelo previamente entrenado utilizando datos relacionados con una tarea o dominio específico. El objetivo es conservar las capacidades generales aprendidas durante el preentrenamiento y mejorar al mismo tiempo el rendimiento en un contexto más concreto.
Qué significa fine-tuning
Fine-tuning puede traducirse como ajuste fino. El término describe precisamente la idea de tomar un modelo que ya ha aprendido patrones generales y realizar ajustes adicionales para orientarlo hacia un comportamiento más específico.
Para qué sirve el fine-tuning
Puede utilizarse para especializar un modelo en programación, atención al cliente, clasificación de textos, documentación jurídica, terminología médica, generación de respuestas con un estilo determinado o cualquier otra tarea en la que el comportamiento general del modelo no sea suficientemente preciso o consistente.
Por qué se utiliza sobre modelos preentrenados
Entrenar un modelo de gran tamaño desde cero exige enormes cantidades de información, hardware especializado y capacidad de cálculo. El fine-tuning reutiliza ese aprendizaje previo, por lo que normalmente necesita menos datos y recursos para alcanzar un buen rendimiento en una tarea específica.
Qué relación tiene con el aprendizaje por transferencia
El fine-tuning puede considerarse una técnica dentro del aprendizaje por transferencia. En ambos casos se aprovecha el conocimiento adquirido previamente por un modelo y se reutiliza como punto de partida para resolver una nueva tarea.
¿Cómo funciona el fine-tuning?
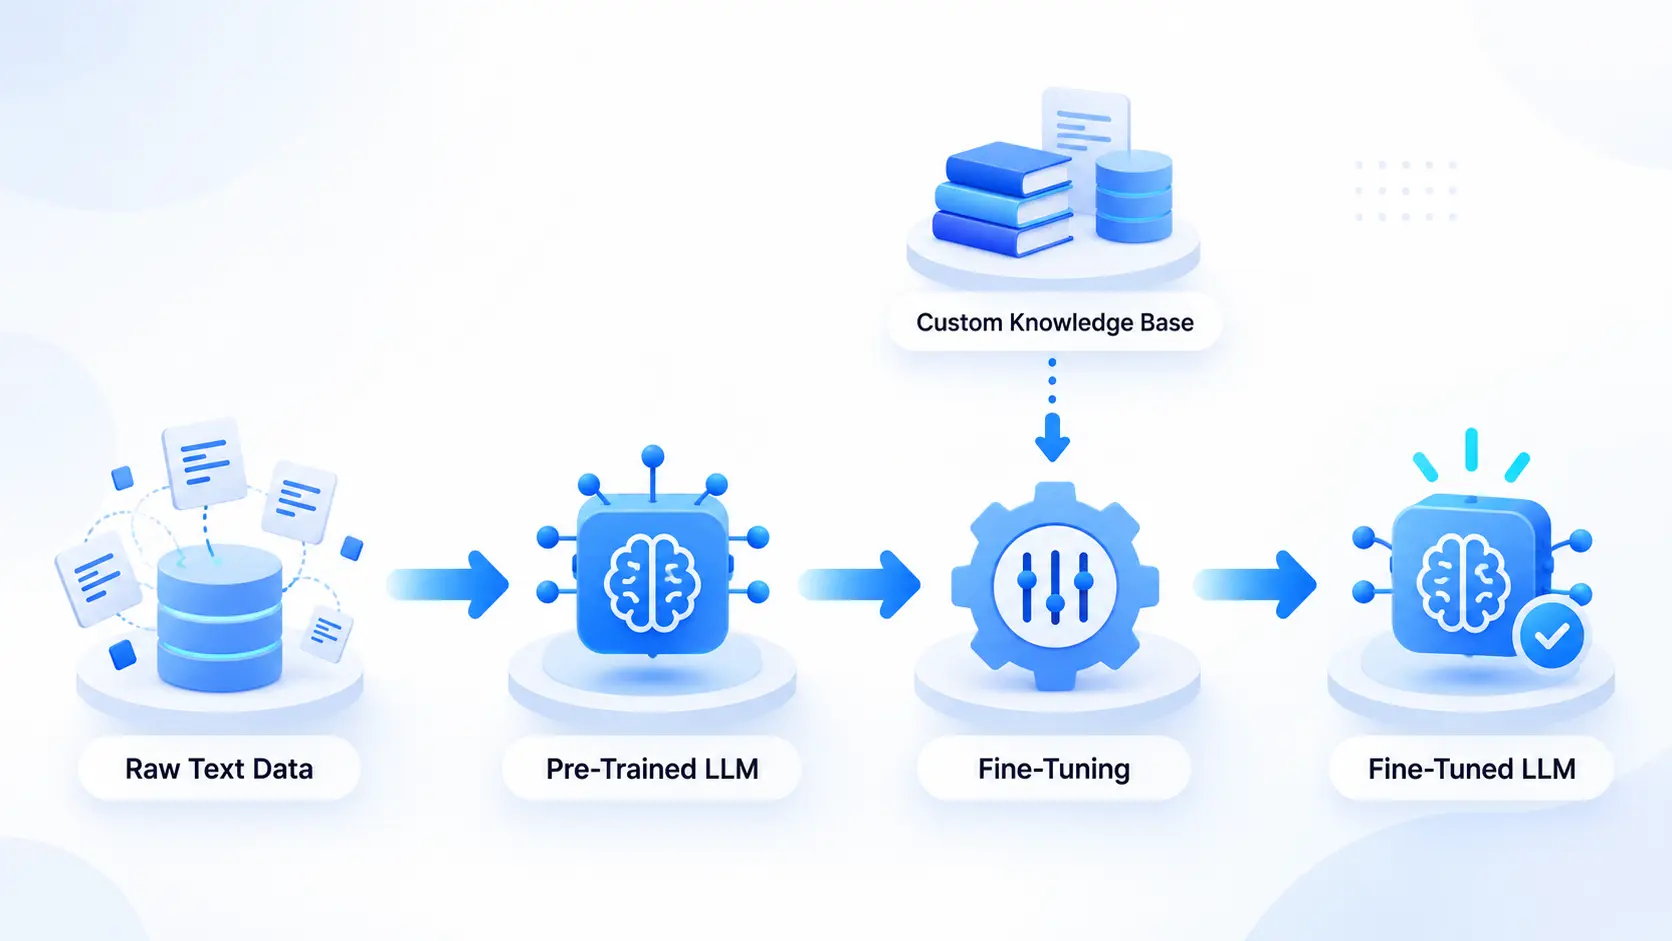
El proceso comienza con un modelo que ya ha pasado por una fase de preentrenamiento. A partir de ahí se selecciona un conjunto de datos que represente correctamente el comportamiento que queremos conseguir y se continúa el entrenamiento durante un número limitado de iteraciones.
Partir de un modelo previamente entrenado
El modelo base ya dispone de parámetros ajustados durante un entrenamiento previo realizado con grandes cantidades de información. Esto proporciona una base general de conocimiento y capacidades que no necesitamos reconstruir.
Preparar un conjunto de datos específico
Después se prepara un dataset relacionado directamente con la tarea objetivo. Puede incluir pares de instrucciones y respuestas, ejemplos de clasificación, fragmentos de código, imágenes etiquetadas o cualquier otro tipo de información compatible con el modelo.
Continuar el entrenamiento
El modelo procesa esos ejemplos y compara sus resultados con las respuestas esperadas. A partir de los errores detectados, el algoritmo de optimización modifica determinados parámetros.
Ajustar los pesos del modelo
Dependiendo de la técnica utilizada, pueden actualizarse todos los pesos o solamente una pequeña parte. El objetivo es modificar lo suficiente el comportamiento para mejorar la tarea concreta sin destruir las capacidades generales aprendidas previamente.
Evaluar el rendimiento
El modelo ajustado debe probarse con datos diferentes a los utilizados durante el entrenamiento. Esta evaluación permite comprobar si realmente ha aprendido la tarea y si mantiene un buen comportamiento ante ejemplos nuevos.
Repetir el proceso hasta obtener el resultado esperado
Normalmente se necesitan varias iteraciones para ajustar dataset, tasa de aprendizaje, número de épocas y otros hiperparámetros hasta conseguir un equilibrio adecuado entre especialización y capacidad de generalización.
Diferencia entre preentrenamiento y fine-tuning
Qué ocurre durante el preentrenamiento
Durante el preentrenamiento el modelo parte de parámetros todavía no especializados y procesa enormes cantidades de información. El objetivo es aprender representaciones generales que posteriormente puedan reutilizarse.
Qué ocurre durante el fine-tuning
El fine-tuning parte de esos parámetros ya aprendidos y realiza un entrenamiento adicional con información más específica. Por tanto, el punto de partida es mucho más avanzado.
Por qué no son lo mismo
El preentrenamiento crea las capacidades generales del modelo. El fine-tuning aprovecha esas capacidades para orientar el sistema hacia una necesidad más concreta.
¿Qué datos se utilizan para hacer fine-tuning?
Datos específicos de una tarea
El dataset debe reflejar el comportamiento que queremos conseguir. Un modelo destinado a programación necesitará ejemplos relacionados con código, mientras que un sistema de clasificación necesitará muestras representativas de las categorías que debe aprender.
Datos etiquetados
En el fine-tuning supervisado es habitual utilizar ejemplos en los que se especifica claramente la entrada y la salida correcta. Estas etiquetas proporcionan al modelo una referencia durante el aprendizaje.
Datos propios de una empresa
Una organización puede utilizar ejemplos generados a partir de su propia actividad si cuenta con permisos y condiciones adecuadas. Esto puede ayudar a especializar el comportamiento en terminología, formatos y procesos internos.
Ejemplos de entrada y salida
En modelos conversacionales es frecuente preparar pares de prompt y respuesta. Cada ejemplo muestra al modelo cómo debería comportarse ante una determinada petición.
Importancia de la calidad del dataset
La calidad de los ejemplos es fundamental. Un conjunto con errores, inconsistencias, sesgos o respuestas poco representativas puede enseñar al modelo comportamientos que después se reproducirán en producción.
Tipos de fine-tuning
Fine-tuning completo
El fine-tuning completo actualiza todos los parámetros del modelo. Conceptualmente es la opción más directa, pero también la que necesita mayor capacidad de cálculo y memoria.
Fine-tuning parcial
El ajuste parcial modifica solamente determinadas capas o parámetros y mantiene congelado el resto. Esto permite reducir los recursos necesarios y conservar una mayor parte del comportamiento original.
Fine-tuning eficiente en parámetros o PEFT
PEFT agrupa diferentes técnicas destinadas a reducir el número de parámetros que deben entrenarse. Esto resulta especialmente importante en modelos con miles de millones de parámetros, donde un ajuste completo puede resultar demasiado caro o poco práctico.
Fine-tuning aditivo
En lugar de modificar directamente todos los parámetros existentes, algunos métodos añaden nuevos componentes al modelo y entrenan únicamente esas partes adicionales.
Adaptadores
Los adaptadores son pequeños módulos añadidos a diferentes capas de la red. El modelo original permanece congelado y solamente se entrenan estos componentes, lo que permite especializarlo utilizando muchos menos parámetros.
LoRA
LoRA, o Low-Rank Adaptation, es una de las técnicas PEFT más conocidas. En lugar de actualizar directamente las grandes matrices de pesos del modelo, añade matrices mucho más pequeñas que representan los cambios necesarios para adaptar su comportamiento.
QLoRA
QLoRA combina LoRA con técnicas de cuantificación para reducir todavía más los requisitos de memoria. De esta forma resulta posible adaptar modelos grandes utilizando infraestructuras más accesibles que las necesarias para un fine-tuning completo.
¿Qué es LoRA y qué relación tiene con el fine-tuning?
Qué significa Low-Rank Adaptation
Low-Rank Adaptation es una técnica que busca representar las modificaciones necesarias mediante matrices de menor dimensión. En lugar de reentrenar todo el modelo, se optimiza un conjunto mucho más reducido de parámetros.
Cómo funciona LoRA
Las ponderaciones originales permanecen congeladas. LoRA introduce pequeñas matrices adicionales que aprenden los cambios necesarios para adaptar el comportamiento del modelo a una nueva tarea.
Por qué reduce los parámetros entrenables
En lugar de modificar miles de millones de pesos, se entrena solamente una pequeña fracción. Esto reduce memoria, capacidad de cálculo y espacio de almacenamiento.
Ventajas frente al fine-tuning completo
LoRA puede acelerar el entrenamiento y permite mantener diferentes adaptaciones específicas sin tener que almacenar una copia completa del modelo por cada tarea.
Qué es QLoRA
QLoRA utiliza una versión cuantificada del modelo base junto con LoRA. La reducción de precisión disminuye el consumo de memoria y facilita realizar ajustes sobre modelos grandes con menos hardware.
Fine-tuning de modelos de lenguaje de gran tamaño
Los modelos de lenguaje de gran tamaño se preentrenan con grandes cantidades de texto y código para aprender capacidades lingüísticas generales. El fine-tuning permite transformar esa base generalista en un modelo mejor adaptado a necesidades específicas.
Por qué se afinan los LLM
Un modelo generalista puede saber mucho sobre numerosos temas y aun así comportarse de forma poco consistente en una tarea específica. El fine-tuning permite reducir esa distancia entre capacidad general y comportamiento esperado.
Adaptar un modelo a instrucciones
Mediante ejemplos adecuados, un modelo puede aprender a interpretar mejor instrucciones y responder siguiendo la estructura que espera el usuario.
Especializarlo en una tarea
Un LLM puede especializarse en clasificación, programación, generación de resúmenes, extracción de información o cualquier otra tarea para la que exista un dataset representativo.
Modificar tono y estilo
También puede entrenarse para adoptar patrones específicos de redacción, estructuras o comportamientos comunicativos.
Incorporar conocimiento de dominio
En sectores con terminología especializada, como derecho, medicina o finanzas, puede utilizarse información de dominio para mejorar el comportamiento en escenarios que estaban poco representados durante el preentrenamiento.
¿Qué es el instruction tuning?
Cómo funciona el ajuste de instrucciones
El instruction tuning utiliza ejemplos diseñados para enseñar al modelo a interpretar peticiones y responder de una forma más útil. Es especialmente frecuente en modelos destinados a asistentes conversacionales.
Pares de instrucción y respuesta
El dataset puede incluir ejemplos como “resume este texto”, “clasifica esta frase” o “traduce este contenido”, acompañados de la respuesta que se considera correcta.
Diferencia entre completar texto y seguir instrucciones
Durante el preentrenamiento, un modelo de lenguaje aprende fundamentalmente patrones que le permiten continuar secuencias. El ajuste de instrucciones ayuda a transformar esa capacidad en respuestas que sigan de forma más directa la intención expresada por el usuario.
Fine-tuning y RLHF: ¿son lo mismo?
Fine-tuning y RLHF están relacionados, pero no son exactamente lo mismo. El fine-tuning tradicional suele utilizar ejemplos de entrenamiento directamente, mientras que RLHF incorpora preferencias humanas dentro de un proceso de aprendizaje por refuerzo.
Qué es RLHF
RLHF significa Reinforcement Learning from Human Feedback. Personas evalúan o comparan diferentes respuestas y esas preferencias se utilizan para orientar el comportamiento posterior del modelo.
Qué aporta el feedback humano
Resulta especialmente útil para enseñar cualidades difíciles de representar mediante reglas simples, como determinados estilos de respuesta, preferencias o comportamientos conversacionales.
Cuándo se combina con fine-tuning
Un modelo puede pasar primero por un fine-tuning supervisado y después por una fase de alineación mediante preferencias humanas. Son técnicas complementarias dentro del ciclo de adaptación.
Fine-tuning vs prompt engineering
Cuándo basta con un buen prompt
Si el modelo ya dispone de las capacidades necesarias y solamente necesita instrucciones claras, el prompting suele ser más rápido y económico que entrenar una nueva adaptación.
Cuándo empieza a compensar hacer fine-tuning
Puede resultar interesante cuando el mismo comportamiento debe repetirse a gran escala, el formato tiene que ser consistente o el modelo sigue fallando aunque las instrucciones sean suficientemente detalladas.
Fine-tuning vs RAG: ¿cuál es la diferencia?
Cuándo utilizar fine-tuning
Cuando el problema está principalmente relacionado con cómo debe comportarse el modelo, qué formato debe utilizar o cómo debe resolver una tarea repetitiva, el fine-tuning puede ser una buena opción.
Cuándo utilizar RAG
Cuando la necesidad principal consiste en proporcionar información específica, cambiante o actualizada, RAG suele ser más adecuado porque recupera los datos necesarios en cada consulta.
Cuándo combinar ambos
Ambas técnicas son complementarias. Un modelo puede fine-tunearse para responder con un estilo y estructura concretos y utilizar RAG para acceder a la documentación actualizada necesaria para cada respuesta.
Fine-tuning vs entrenamiento desde cero
Coste computacional
Entrenar un modelo grande desde cero puede exigir una infraestructura considerable durante largos periodos. El fine-tuning necesita normalmente una fracción de esos recursos.
Cantidad de datos
El preentrenamiento utiliza conjuntos masivos. Para fine-tuning puede ser suficiente un dataset mucho más reducido si está bien diseñado y representa correctamente la tarea.
Riesgo de sobreajuste
Entrenar desde cero con pocos datos puede provocar que el modelo memorice ejemplos y generalice mal. El fine-tuning parte de representaciones generales ya aprendidas y permite trabajar con conjuntos más pequeños, aunque también debe controlarse el sobreajuste.
Ventajas del fine-tuning
Personalización
Permite adaptar el comportamiento del modelo al tipo de tarea, lenguaje o formato requerido.
Mayor consistencia
Cuando existen ejemplos de entrenamiento bien definidos, el modelo puede aprender a repetir estructuras y comportamientos con mayor regularidad.
Especialización
Un modelo general puede convertirse en una herramienta mucho más adecuada para programación, clasificación o un dominio especializado.
Menor coste que entrenar desde cero
Reutilizar un modelo preentrenado permite evitar buena parte del coste asociado a desarrollar capacidades generales desde el principio.
Adaptación al lenguaje de un sector
Los ejemplos específicos pueden ayudar al modelo a desenvolverse mejor con vocabulario y estructuras propias de sectores especializados.
Limitaciones y riesgos del fine-tuning
Sobreajuste
Si se entrena demasiado sobre un conjunto pequeño, el modelo puede aprender excesivamente los ejemplos disponibles y perder capacidad de generalización.
Olvido catastrófico
El olvido catastrófico ocurre cuando el proceso de adaptación modifica demasiado el modelo y deteriora conocimientos o capacidades que ya había aprendido durante el preentrenamiento.
Dataset de baja calidad
Los errores presentes en los datos pueden trasladarse directamente al comportamiento del modelo. La preparación y revisión del dataset es una de las fases más importantes.
Coste computacional
Aunque sea menor que entrenar desde cero, el ajuste de modelos grandes sigue necesitando recursos. Técnicas como LoRA y QLoRA ayudan precisamente a reducirlos.
Sesgos
Si el conjunto de ajuste contiene patrones sesgados o poco representativos, el comportamiento final puede amplificarlos.
Casos de uso del fine-tuning
Chatbots
Un chatbot puede ajustarse para seguir estructuras concretas, responder con determinados niveles de detalle o manejar mejor tipos específicos de consulta.
Atención al cliente
El modelo puede entrenarse con ejemplos representativos del estilo y formato que debe utilizar el sistema de soporte.
Programación
Puede especializarse en determinados lenguajes, patrones de desarrollo o tareas relacionadas con generación y revisión de código.
Modelos jurídicos, financieros o médicos
Los sectores especializados utilizan terminología y estructuras que pueden estar poco representadas en los datos generales. El fine-tuning puede mejorar el comportamiento del modelo dentro de esos dominios, siempre acompañado de las validaciones necesarias.
Clasificación de textos
Puede adaptarse para clasificar mensajes, documentos o registros siguiendo categorías específicas del negocio.
Generación de contenido con un estilo concreto
Los ejemplos de entrenamiento pueden ayudar al modelo a reproducir estructuras, formatos y determinados patrones de redacción.
Ejemplo práctico de fine-tuning en una empresa
Imaginemos que una empresa quiere desarrollar un asistente interno capaz de responder preguntas sobre procedimientos. Además de proporcionar la respuesta correcta, necesita que siempre sea breve, directa y siga una estructura determinada.
Partir de un LLM generalista
El primer paso puede ser seleccionar un modelo que ya tenga buenas capacidades generales de lenguaje.
Crear ejemplos de pregunta y respuesta
Después se prepara un corpus con preguntas representativas y respuestas redactadas exactamente con el formato que queremos enseñar.
Fine-tunear el modelo
Los ejemplos se utilizan para modificar el comportamiento del modelo y hacerlo más consistente ante consultas similares.
Evaluar las respuestas
Es necesario comprobar tanto la precisión como la estructura de las respuestas utilizando un conjunto de pruebas independiente.
Conectarlo con documentación mediante RAG
El modelo ajustado puede combinarse posteriormente con RAG para recuperar los procedimientos actualizados y utilizar esa información como contexto. De esta manera, el fine-tuning controla principalmente el comportamiento y RAG aporta el conocimiento actualizado.
¿Cuándo debería una empresa utilizar fine-tuning?
Cuando necesita respuestas muy consistentes
Si el modelo debe repetir un patrón concreto de forma continua, entrenarlo con ejemplos puede aportar mayor estabilidad que depender exclusivamente de prompts largos.
Cuando el formato importa
Puede resultar útil si las respuestas tienen que seguir estructuras, categorías o formatos muy concretos de manera repetitiva.
Cuando existe lenguaje especializado
Un dominio con terminología compleja puede beneficiarse de ejemplos específicos siempre que la información y el dataset estén correctamente preparados.
Cuando prompting no es suficiente
Si sucesivas mejoras del prompt no consiguen un comportamiento estable, el fine-tuning puede convertirse en una alternativa razonable.
¿Cuándo no merece la pena hacer fine-tuning?
Cuando el problema se resuelve con prompting
Si un buen conjunto de instrucciones consigue el resultado esperado, entrenar una adaptación adicional puede introducir un coste innecesario.
Cuando solo necesitamos información actualizada
Si el objetivo es que el modelo responda utilizando documentación que cambia frecuentemente, RAG suele resultar más apropiado que incorporar esa información mediante entrenamiento.
Cuando no hay suficientes datos de calidad
Sin ejemplos representativos resulta difícil enseñar correctamente el comportamiento deseado y aumenta el riesgo de sobreajuste.
Cuando el caso de uso cambia constantemente
Los entornos muy variables pueden requerir métodos más flexibles que permitan cambiar instrucciones y contexto sin volver a entrenar el modelo.
Cómo implementar fine-tuning en una empresa
Definir el objetivo
Antes de entrenar nada debe definirse qué comportamiento queremos mejorar y cómo se medirá el resultado.
Elegir el modelo base
El modelo debe disponer de buenas capacidades iniciales relacionadas con la tarea. Cuanto mejor sea el punto de partida, menor puede ser el esfuerzo necesario para adaptarlo.
Preparar el dataset
Los ejemplos deben revisarse, normalizarse y separarse correctamente entre entrenamiento y evaluación.
Seleccionar la técnica de fine-tuning
Dependiendo del modelo, infraestructura y objetivo puede utilizarse ajuste completo, PEFT, LoRA, QLoRA u otros métodos.
Entrenar y evaluar
El entrenamiento debe ir acompañado de métricas y pruebas capaces de detectar tanto mejoras como posibles pérdidas de capacidades.
Desplegar y monitorizar resultados
Una vez en producción, el comportamiento debe seguir evaluándose porque pueden aparecer nuevos casos, errores o necesidades que requieran nuevos ajustes.
Fine-tuning dentro de una estrategia de IA empresarial
No empezar por la tecnología
El objetivo no debe ser fine-tunear un modelo porque la técnica esté disponible, sino resolver un problema empresarial concreto.
Analizar el proceso
Es necesario entender qué tarea se quiere automatizar, qué errores existen actualmente y qué nivel de consistencia necesita el sistema.
Decidir entre prompting, RAG y fine-tuning
Cada técnica resuelve problemas diferentes. El prompting modifica las instrucciones, RAG aporta información contextual y el fine-tuning modifica el comportamiento aprendido del modelo.
Combinar técnicas cuando sea necesario
En muchos proyectos, la mejor arquitectura no consiste en elegir una única opción, sino en combinar un modelo ajustado con prompting, RAG, herramientas y controles adicionales.
Integrar el modelo con ERP, CRM y herramientas internas
El valor empresarial aparece cuando el modelo forma parte del proceso real y puede trabajar con información, aplicaciones y permisos correctamente definidos.
En Process Control analizamos cada caso de uso antes de decidir si conviene utilizar fine-tuning, prompting, RAG u otras técnicas. Nuestra consultoría e implementación de Inteligencia Artificial para empresas permite diseñar modelos e integraciones adaptados a los datos, procesos y sistemas reales de la organización.
La integración de la inteligencia artificial con los sistemas ERP permite automatizar tareas, aprovechar los datos empresariales y optimizar la toma de decisiones. En este vídeo puedes descubrir cómo se relacionan ambas tecnologías y qué oportunidades ofrecen para mejorar la eficiencia de los procesos empresariales.
Preguntas frecuentes sobre fine-tuning
¿Qué significa fine-tuning?
Fine-tuning significa ajuste fino y consiste en continuar entrenando un modelo previamente entrenado con datos más específicos para adaptarlo a una tarea o comportamiento concreto.
¿Para qué sirve el fine-tuning?
Sirve para especializar modelos, mejorar consistencia, adaptar estilos, enseñar formatos y optimizar el rendimiento en tareas o dominios específicos.
¿Qué diferencia hay entre fine-tuning y entrenamiento?
El preentrenamiento crea las capacidades generales del modelo utilizando grandes volúmenes de información. El fine-tuning parte de ese modelo ya entrenado y lo adapta con datos más específicos.
¿Qué diferencia hay entre fine-tuning y prompt engineering?
El prompt engineering modifica las instrucciones que recibe el modelo, mientras que el fine-tuning modifica total o parcialmente los parámetros o componentes entrenables del sistema.
¿Qué diferencia hay entre fine-tuning y RAG?
El fine-tuning adapta el comportamiento aprendido del modelo. RAG recupera información externa y se la proporciona como contexto sin modificar sus parámetros.
¿Qué es LoRA?
LoRA es una técnica de fine-tuning eficiente que mantiene congelados los pesos principales del modelo y entrena matrices adicionales mucho más pequeñas.
¿Qué es QLoRA?
QLoRA combina cuantificación y LoRA para reducir todavía más el consumo de memoria durante el ajuste de modelos grandes.
¿Qué es PEFT?
PEFT significa Parameter-Efficient Fine-Tuning y agrupa métodos que reducen la cantidad de parámetros que deben entrenarse para adaptar un modelo.
¿Qué es instruction tuning?
Es un tipo de ajuste que utiliza ejemplos de instrucciones y respuestas para enseñar al modelo a seguir mejor las peticiones del usuario.
¿Fine-tuning y RLHF son lo mismo?
No. El fine-tuning puede utilizar ejemplos de entrenamiento directamente, mientras que RLHF utiliza preferencias o evaluaciones humanas dentro de un proceso de aprendizaje por refuerzo.
¿Cuántos datos se necesitan para hacer fine-tuning?
No existe una cantidad universal. Depende de la complejidad de la tarea, calidad de los ejemplos, capacidad inicial del modelo y técnica de ajuste utilizada.
¿Se puede hacer fine-tuning de un LLM?
Sí. Los LLM pueden adaptarse mediante diferentes técnicas de fine-tuning para especializarlos en instrucciones, dominios, estilos y tareas concretas.
¿Puede una empresa hacer fine-tuning con sus propios datos?
Sí, siempre que disponga de datos adecuados, permisos para utilizarlos y un proceso correcto de preparación, entrenamiento y evaluación.
¿Es más barato que entrenar un modelo desde cero?
Generalmente sí, porque aprovecha un modelo que ya ha realizado el costoso proceso de preentrenamiento y necesita menos datos y capacidad computacional para especializarse.
¿Cuándo merece la pena utilizar fine-tuning?
Cuando existe una tarea repetitiva y bien definida, se dispone de ejemplos de calidad y prompting o RAG por sí solos no consiguen el comportamiento, formato o nivel de consistencia necesarios.