Un embedding es una representación numérica de información (como una palabra, un documento, una imagen o un audio) que permite a los sistemas de inteligencia artificial identificar relaciones y similitudes entre distintos elementos. En lugar de trabajar únicamente con el texto o las imágenes tal como los percibimos, los modelos convierten esa información en vectores de números que pueden comparar matemáticamente. Esta tecnología es fundamental para la búsqueda semántica, los sistemas de recomendación y muchas aplicaciones de inteligencia artificial generativa. También permite desarrollar asistentes que consultan documentación interna, una posibilidad especialmente interesante para las empresas que buscan integrar la IA en sus procesos. En proyectos empresariales, este tipo de tecnología necesita conectarse con una necesidad real: recuperar documentación, relacionar datos o facilitar consultas. Por eso, una consultoría de IA para empresas puede ayudar a decidir si utilizar embeddings aporta valor y cómo integrarlos con los sistemas existentes.
¿Cómo funcionan los embeddings en inteligencia artificial?
Un embedding no es una etiqueta que alguien asigna a un texto ni una traducción literal de sus palabras a cifras. Es una representación aprendida: el modelo transforma la entrada en una posición dentro de un espacio de características y utiliza esa posición para comparar ejemplos. Por eso, dos textos con expresiones distintas pueden aparecer relacionados, mientras que dos frases que comparten términos pueden resultar poco próximas si hablan de asuntos diferentes. La utilidad de esa comparación depende tanto del entrenamiento como del modo en que se calcula la similitud.
En la práctica, lo importante no es interpretar individualmente las coordenadas, sino comprobar si las relaciones entre ellas son útiles para la tarea. Un buscador documental necesita recuperar procedimientos pertinentes; una aplicación de recomendación debe identificar productos similares; y un clasificador, distinguir categorías con la menor tasa de error posible. Para saberlo, las representaciones se prueban con ejemplos que no se hayan utilizado para ajustar el sistema.
Un vector es una secuencia ordenada de números. Por ejemplo, un modelo podría representar una frase mediante valores como [0,12; -0,45; 0,78; ...]. Los números son ilustrativos: los embeddings reales suelen incluir cientos o miles de dimensiones y sus valores dependen del modelo utilizado. No existe una traducción universal en la que cada número corresponda directamente a una característica comprensible para una persona. El significado se distribuye entre las dimensiones del vector y emerge de las relaciones aprendidas durante el entrenamiento.
Cuando un modelo produce embeddings para varios elementos, estos pueden compararse mediante medidas como la similitud del coseno o la distancia euclidiana. En modelos entrenados para representar significado, los textos relacionados suelen obtener vectores próximos según la métrica elegida. Esto hace posible encontrar información relevante aunque una consulta y un documento no compartan exactamente las mismas palabras. No obstante, la proximidad vectorial no demuestra por sí sola que dos afirmaciones sean equivalentes o verdaderas: únicamente indica similitud según la representación que ha aprendido el modelo.
Imaginemos que una empresa almacena dos documentos: uno sobre «mantenimiento de vehículos de empresa» y otro sobre «revisión de la flota corporativa». Un empleado pregunta: «¿Cada cuánto hay que revisar los coches de la compañía?». Una búsqueda basada únicamente en coincidencias literales podría pasar por alto información útil. En cambio, un sistema de búsqueda semántica puede generar un embedding de la pregunta y compararlo con los de los documentos. Si las representaciones resultan próximas, el sistema recuperará el contenido sobre revisión de flotas, aunque la redacción sea diferente. El ejemplo muestra la utilidad del embedding, pero también sus límites: encontrar un documento parecido no significa que responda correctamente a la consulta. Es necesario comprobar su pertinencia.
¿Para qué sirven los embeddings?
Su principal aportación es abrir una vía de acceso a información que no depende exclusivamente de las palabras exactas utilizadas en una búsqueda. Los embeddings pueden facilitar que una solicitud del cliente se relacione con una incidencia anterior, que una descripción de producto encuentre artículos parecidos o que documentos escritos con terminología diferente se agrupen por asunto. En todos esos escenarios, la similitud es una señal que debe combinarse con el contexto y con las reglas de la aplicación.
Cuando los resultados tienen consecuencias operativas, conviene diferenciar la recuperación de información de la toma de decisiones. Un sistema puede sugerir documentos, agrupar mensajes o proponer coincidencias, pero no debería confirmar automáticamente la validez de una factura, resolver una reclamación o atribuir un fraude solo porque dos vectores estén próximos.
La aplicación más directa consiste en reconocer elementos relacionados. Por ejemplo, un catálogo puede agrupar productos con características semejantes o un sistema documental puede detectar textos que tratan sobre un mismo asunto. El resultado depende de los datos de entrenamiento y de la adecuación del modelo al dominio de trabajo.
Los buscadores semánticos comparan la representación de una consulta con las representaciones de los contenidos indexados. Esto ayuda a encontrar respuestas aunque el usuario formule la pregunta con sinónimos o expresiones diferentes. Suele combinarse con filtros, búsqueda por palabras clave y técnicas de reordenación de resultados para mejorar la precisión.
Un embedding puede utilizarse como entrada para otros modelos de machine learning. En lugar de analizar directamente una frase o una imagen, el sistema trabaja con una representación numérica que ya recoge parte de sus características relevantes. Esto facilita tareas como clasificación, agrupación y detección de patrones.
En los sistemas de recomendación pueden crearse representaciones de artículos y, según el diseño, de usuarios. Al comparar estos vectores, el sistema estima qué productos, contenidos o servicios podrían resultar relevantes. Las recomendaciones también suelen incorporar otros datos, como disponibilidad, historial de interacciones o reglas del negocio.
Tipos de embeddings: texto, imágenes, audio y modelos multimodales
La palabra embedding suele asociarse al texto, pero la idea se aplica a muchos tipos de datos. Lo que cambia es la información que aprende a representar el modelo: relaciones entre palabras, significado de párrafos, características visuales o patrones acústicos. Por ello, elegir el tipo de embedding correcto es más relevante que acumular vectores de forma indiscriminada. Un sistema preparado para comparar frases no tiene por qué servir para localizar imágenes de productos.
Las representaciones multimodales amplían estas posibilidades al relacionar diferentes formatos. Por ejemplo, un catálogo con fotografías puede permitir búsquedas mediante descripciones escritas, siempre que el modelo haya sido preparado para situar ambos tipos de contenido en espacios compatibles. La precisión debe evaluarse con imágenes y consultas reales, especialmente cuando los objetos tienen variaciones pequeñas o vocabulario técnico.
Los word embeddings representan palabras como vectores. Métodos como Word2Vec o GloVe permitieron modelar relaciones entre términos a partir de sus contextos de aparición. Muchos de estos enfoques clásicos generan una representación fija para cada palabra, por lo que tienen dificultades cuando un término cambia de significado según la frase.
Los text embeddings representan frases, párrafos o documentos completos. Son especialmente útiles para comparar consultas con fragmentos de documentación. Algunos modelos tienen en cuenta el contexto para distinguir mejor significados y usos del lenguaje, una ventaja para la búsqueda semántica y la clasificación documental.
En visión artificial, los embeddings pueden representar patrones visuales, objetos o rasgos relevantes de una imagen. Se emplean para buscar fotografías similares, organizar catálogos visuales o detectar imágenes relacionadas. Dos imágenes visualmente parecidas no siempre describen el mismo objeto, por lo que la elección del modelo es importante.
Los embeddings de audio permiten representar señales sonoras mediante vectores. Se utilizan, por ejemplo, en clasificación de sonidos, búsqueda por similitud acústica y otras aplicaciones de procesamiento de voz o música. La representación puede centrarse en aspectos distintos según el objetivo del sistema.
Los modelos multimodales pueden situar información de distintos formatos en espacios comparables. Así, una descripción escrita como «camión azul en un almacén» podría utilizarse para recuperar imágenes relacionadas. Esto resulta útil en búsquedas de catálogos, archivos audiovisuales y sistemas que combinan texto e imagen.
¿Cómo se crean los embeddings y qué modelos se utilizan?
Crear embeddings es solo una parte del trabajo. Para construir una aplicación fiable también hay que decidir qué información se representa, cómo se divide y cuándo debe actualizarse. Una política interna de veinte páginas, por ejemplo, puede contener varios procedimientos diferentes: convertirla en un único vector podría dificultar encontrar el apartado que responde a una pregunta concreta. Dividirla sin criterio tampoco es buena solución, porque puede separar una norma de sus excepciones.
Esta preparación determina buena parte de la calidad del sistema. El texto necesita limpieza, los fragmentos deben conservar una referencia al documento de origen y el índice ha de actualizarse cuando cambien los contenidos. Además, las consultas y los documentos tienen que codificarse con representaciones compatibles; de lo contrario, las comparaciones dejan de ser fiables.
El primer paso consiste en elegir un modelo compatible con el tipo de contenido y el objetivo: texto, imágenes, audio o datos multimodales. También conviene evaluar aspectos como el idioma, la calidad de recuperación, la latencia, el coste y las condiciones de tratamiento de datos.
Antes de generar embeddings es necesario organizar la información. En una base documental, esto puede implicar eliminar duplicados, corregir errores y dividir documentos extensos en fragmentos coherentes. Un fragmento demasiado grande puede mezclar temas; uno demasiado pequeño puede perder contexto.
El modelo procesa cada elemento y devuelve su vector. Para que una comparación sea válida, los embeddings de las consultas y los documentos deben generarse con representaciones compatibles. Cambiar de modelo puede obligar a recalcular los vectores almacenados.
Una vez generados, los vectores pueden guardarse junto con el identificador del documento, sus metadatos y permisos de acceso. Una aplicación los consulta para recuperar elementos próximos, agrupar registros o alimentar otros procesos de inteligencia artificial.
Los primeros modelos populares de embeddings ayudaron a describir relaciones entre palabras a partir de grandes colecciones de texto. Con el tiempo se desarrollaron arquitecturas sensibles al contexto y modelos especializados en búsqueda semántica, capaces de representar frases o documentos completos. Esta evolución explica por qué no siempre sirve utilizar el modelo más conocido: cada familia fue diseñada con objetivos y limitaciones distintos.
Para un proyecto empresarial conviene comparar alternativas sobre un conjunto de preguntas y documentos representativos. Deben valorarse el idioma, los tecnicismos del sector, la latencia, el coste de recalcular índices y las condiciones de tratamiento de datos. Un modelo que destaca en pruebas generales puede recuperar resultados poco útiles en una base de conocimiento especializada.
Word2Vec es una familia de métodos popularizada en 2013 para aprender representaciones de palabras a partir de su contexto. Resultó influyente porque permitió observar relaciones semánticas mediante operaciones vectoriales sin diseñar manualmente cada característica lingüística.
GloVe aprende representaciones de palabras utilizando estadísticas de coaparición recogidas en corpus de texto. Comparte con Word2Vec el objetivo de representar relaciones lingüísticas, aunque parte de un enfoque de entrenamiento diferente.
FastText incorpora información de partes de las palabras, como secuencias de caracteres. Esto puede ayudar a representar términos poco frecuentes y variaciones morfológicas, una característica útil en idiomas con múltiples flexiones.
Con los modelos basados en transformers, como BERT, se popularizaron las representaciones sensibles al contexto: una palabra puede recibir representaciones diferentes dependiendo de la frase en la que aparece. Para búsquedas de frases o documentos suelen utilizarse modelos y ajustes específicos que producen embeddings adecuados para comparar textos completos.
Los modelos actuales pueden entrenarse específicamente para recuperar información, comparar consultas y documentos o relacionar texto con imágenes. No existe un modelo óptimo para todos los escenarios: la elección debe evaluarse sobre ejemplos representativos de la empresa, especialmente cuando hay vocabulario técnico o documentos especializados.
Diferencias entre embeddings y vectores
En una implementación es habitual hablar indistintamente de vectores y embeddings, pero separar ambos conceptos evita confusiones. Un vector es la estructura matemática en la que se expresan coordenadas; el embedding es la representación con significado operativo que un modelo aprende a producir a partir de una entrada. Esa diferencia también explica por qué no pueden compararse sin más los vectores de modelos distintos: aunque tengan la misma longitud, sus coordenadas pueden representar espacios incompatibles.
Aunque suelen aparecer juntos, embedding y vector no significan exactamente lo mismo. Un vector es una estructura matemática: una lista ordenada de números. Un embedding es una representación de un elemento —texto, imagen o producto— que normalmente se expresa mediante un vector aprendido por un modelo.
Por ejemplo, [2, 5, 8] es un vector, pero no tiene por qué ser un embedding. En cambio, la representación numérica de una descripción de producto generada por un modelo de embeddings sí constituye un embedding. Por tanto, todos los embeddings vectoriales se expresan como vectores, pero no todos los vectores son embeddings.
Embeddings y bases de datos vectoriales
Una vez que se generan embeddings para una colección documental, surge una necesidad práctica: encontrar con rapidez los elementos más cercanos al vector de una consulta. Una búsqueda secuencial sobre todos los registros puede ser suficiente para volúmenes pequeños, pero resulta menos eficiente a gran escala. Los índices vectoriales permiten acelerar la recuperación, aunque sus resultados y costes dependen de la estrategia de búsqueda.
La arquitectura también debe conservar los vínculos con los documentos originales. Al usuario no le basta con recibir un texto parecido: necesita saber de qué procedimiento procede, si está actualizado y si tiene permiso para consultarlo. Por ello, los metadatos, las reglas de acceso y la revisión de las fuentes son tan importantes como la base vectorial.
Una base de datos vectorial está diseñada para almacenar, indexar y consultar representaciones numéricas mediante operaciones de similitud. También pueden utilizarse motores de búsqueda o bases de datos tradicionales con funciones vectoriales; no siempre es necesario incorporar una plataforma independiente.
Además del vector, lo habitual es conservar referencias al documento original, información descriptiva y controles de acceso. Cuando llega una consulta, el sistema genera su embedding, busca los vectores similares y devuelve los fragmentos o elementos asociados. Mantener vinculados los vectores con sus fuentes es esencial para que una aplicación pueda mostrar el documento original, comprobar la información y respetar los permisos de cada usuario.
La similitud del coseno compara la orientación de dos vectores, mientras que la distancia euclidiana mide su separación geométrica. Distintas aplicaciones pueden emplear métricas y métodos de indexación diferentes. Para colecciones grandes, se utilizan algoritmos de búsqueda aproximada de vecinos cercanos que permiten obtener resultados con rapidez, a cambio de un posible compromiso entre velocidad y exhaustividad.
¿Qué relación existe entre los embeddings y los sistemas RAG?
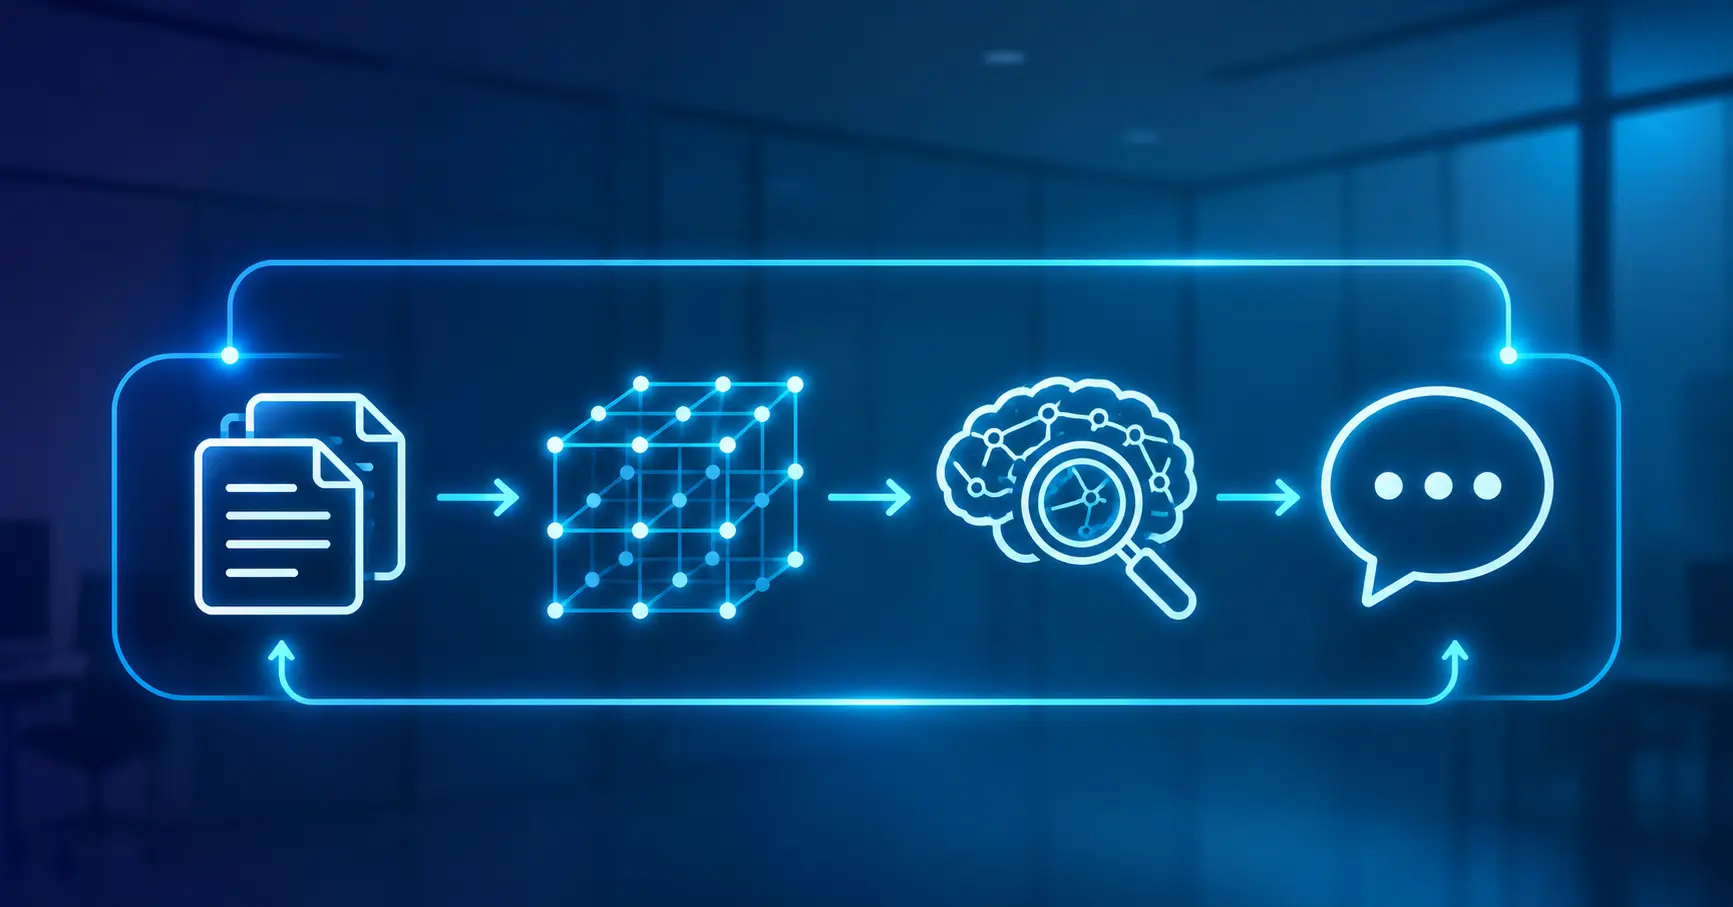
Los embeddings suelen aparecer en conversaciones sobre asistentes que responden utilizando documentación interna. Su función en muchos de esos proyectos es localizar fragmentos relevantes para una pregunta, no redactar por sí mismos la respuesta. La arquitectura RAG combina esa fase de recuperación con un modelo generativo al que se facilita el contexto seleccionado, de forma que pueda basarse en fuentes específicas de la organización.
La calidad de un asistente RAG depende de varios eslabones. Si los documentos están desactualizados, se han dividido mal o el buscador devuelve fragmentos de otro departamento, el modelo puede elaborar una respuesta convincente pero equivocada. Por eso interesa medir tanto la precisión de la recuperación como la fidelidad de las respuestas y ofrecer referencias verificables a los documentos originales.
En una solución RAG, los documentos suelen dividirse en fragmentos y se crean embeddings de cada uno. Ante una pregunta, se genera una representación de la consulta y se buscan los fragmentos más cercanos. Es posible combinar esta fase con búsqueda léxica, filtros de metadatos y un sistema de reordenación para obtener mejores resultados.
Un flujo habitual consiste en preparar los documentos, crear e indexar sus embeddings, recuperar fragmentos relevantes y entregarlos a un modelo de lenguaje para generar la respuesta. Si el sistema está bien diseñado, también puede aportar referencias a los textos utilizados. Sin embargo, recuperar información no garantiza una respuesta correcta. Hay que evaluar la calidad de los fragmentos seleccionados, la fidelidad de la respuesta a las fuentes y el tratamiento de datos sensibles.
Pensemos en una compañía que utiliza manuales de procedimientos, fichas técnicas y políticas internas. Un empleado pregunta: «¿Qué pasos debo seguir para registrar una devolución de proveedor?». El asistente busca fragmentos relevantes, recupera el procedimiento vigente y genera una respuesta basada en ese material. La utilidad está en acceder a conocimiento distribuido sin recorrer manualmente múltiples carpetas. Para que funcione de forma fiable, la empresa necesita mantener la documentación actualizada, aplicar permisos y ofrecer una forma de contrastar la respuesta con el documento original.
Aplicaciones de los embeddings y ejemplos en inteligencia artificial
En el entorno empresarial los embeddings se utilizan como componente de soluciones más amplias, no como una funcionalidad aislada que el usuario deba gestionar. Su presencia puede pasar desapercibida: un empleado introduce una pregunta en un buscador, un cliente recibe recomendaciones o un responsable consulta un repositorio de incidencias, mientras el sistema compara representaciones en segundo plano.
Sus resultados tienen que responder a un objetivo reconocible. Recuperar documentos relevantes, reducir el tiempo empleado en localizar un procedimiento o identificar solicitudes duplicadas son mejoras que pueden medirse. En cambio, crear miles de vectores sin definir qué tarea van a resolver no garantiza ningún beneficio.
Un buscador interno puede identificar documentos relacionados con una pregunta aunque utilicen terminología diferente. Esto resulta útil cuando los empleados desconocen el nombre exacto de un archivo o proceso.
Los asistentes pueden utilizar embeddings para localizar información relevante en bases de conocimiento y aportar contexto a sus respuestas. La comprensión del lenguaje y la generación de texto dependen también de otras partes del sistema, no exclusivamente de los embeddings.
Un comercio electrónico puede comparar representaciones de productos para sugerir artículos semejantes. Otras variables, como el comportamiento del usuario o el stock disponible, ayudan a determinar qué resultados mostrar.
Los embeddings permiten agrupar comunicaciones o documentos por similitud. Por ejemplo, una empresa podría identificar reclamaciones relacionadas con retrasos de entrega y separarlas de consultas sobre facturación, siempre que valide la clasificación.
Una plataforma puede recuperar imágenes relacionadas con una descripción textual o detectar fotografías visualmente similares. Estas funciones pueden mejorar la organización de archivos y catálogos.
En determinados modelos, la representación vectorial de operaciones o relaciones entre entidades ayuda a identificar comportamientos atípicos. Una anomalía es una señal para investigar, no una prueba automática de fraude.
Ventajas y limitaciones de los embeddings
Los embeddings ayudan a comparar información diversa de manera eficiente, pero no son una garantía automática de precisión. La diferencia entre un sistema útil y uno que acumula resultados irrelevantes está en la calidad del modelo, de los datos y de la evaluación. En proyectos reales interesa comprobar cuánto mejora la recuperación frente a una búsqueda convencional, cómo se comporta el sistema con lenguaje especializado y qué errores aparecen cuando cambian las fuentes.
La principal ventaja es que permiten comparar información por relaciones aprendidas y no solo por coincidencia literal. También facilitan la reutilización de representaciones en tareas de búsqueda, clasificación y recomendación. Cuando se combinan con una arquitectura adecuada, pueden mejorar el acceso a información dispersa y ayudar a construir aplicaciones de IA más contextuales.
Los embeddings también presentan dificultades. Pueden reflejar sesgos de sus datos de entrenamiento, interpretar incorrectamente términos especializados o recuperar textos relacionados pero irrelevantes para una pregunta concreta. Además, la calidad depende del modelo, de cómo se dividen los documentos y de la estrategia de búsqueda. Desde una perspectiva empresarial, deben considerarse el coste de generación y almacenamiento, la actualización del índice cuando cambian los documentos, la protección de datos y la evaluación periódica con consultas reales. La similitud numérica no sustituye la validación humana en decisiones sensibles.
¿Cómo se utilizan los embeddings en las empresas?
Antes de introducir embeddings en una organización conviene localizar procesos en los que buscar o comparar información consume un tiempo excesivo. Los casos más adecuados suelen implicar documentos, consultas o catálogos con suficiente volumen y variedad de expresiones. Después hay que decidir de dónde procede el contenido, quién puede verlo y qué ocurrirá cuando no aparezca una respuesta suficientemente fiable.
En proyectos conectados con software de gestión también es esencial no confundir documentación con datos operativos en tiempo real. Un embedding puede ayudar a recuperar las instrucciones para gestionar una devolución; conocer si una factura concreta está pagada exige una consulta autorizada al ERP. La combinación de ambas capacidades requiere una arquitectura clara y controles diferenciados.
Una organización puede conectar manuales, procedimientos y documentación técnica a un buscador semántico. Los empleados localizarían información mediante preguntas formuladas en lenguaje natural, con independencia de que conozcan el nombre exacto del documento.
En atención al cliente, los embeddings permiten recuperar respuestas desde artículos de ayuda, fichas de producto o documentación comercial. Es fundamental que el sistema distinga entre información publicada para clientes y contenido interno restringido.
La conexión con un ERP o CRM puede aportar contexto actualizado a determinados asistentes: documentación de productos, procedimientos, condiciones comerciales o incidencias registradas. Los embeddings facilitan la recuperación de contenidos, mientras que las consultas a datos transaccionales y la ejecución de acciones requieren integraciones, permisos y verificaciones específicas. Por ejemplo, un asistente podría localizar las instrucciones para gestionar una incidencia de pedido, pero consultar el estado actual de ese pedido exigiría acceso controlado al sistema de gestión. Diferenciar ambas funciones evita atribuir a una búsqueda vectorial capacidades que no tiene por sí sola.
Antes de incorporar embeddings a un proceso conviene identificar qué información necesita recuperar el usuario, cómo se actualiza y qué nivel de precisión exige el negocio. En Process Control, una consultoría de inteligencia artificial puede servir como punto de partida para estudiar la viabilidad de estas soluciones y su integración con las herramientas existentes.
Preguntas frecuentes sobre embeddings
Las dudas más frecuentes sobre embeddings suelen aparecer cuando se intenta pasar de la definición técnica a un uso concreto: qué representan esos números, cómo se generan y por qué se relacionan con la búsqueda semántica o los sistemas RAG. Resolver estas cuestiones ayuda a evitar un error común: asumir que una similitud matemática equivale siempre a una respuesta correcta. Las siguientes preguntas resumen los conceptos fundamentales y aclaran qué puede aportar esta tecnología dentro de una solución de inteligencia artificial.
¿Qué significa embedding en inteligencia artificial?
Un embedding es una representación numérica que un modelo aprende a generar a partir de un elemento, como una palabra, un texto, una imagen o un audio. Habitualmente se expresa como un vector de números cuya posición permite comparar características y relaciones con otros elementos. Su utilidad no reside en leer cada cifra por separado, sino en usar el conjunto para localizar información o identificar patrones de similitud.
¿Para qué sirve un embedding?
Sirve para comparar datos que resultaría difícil relacionar mediante coincidencias literales. Los embeddings se emplean en buscadores semánticos, sistemas de recomendación, clasificación documental y recuperación de información para asistentes de IA. Por ejemplo, ayudan a encontrar un procedimiento aunque el empleado lo describa con palabras distintas de las que aparecen en su título. El resultado debe verificarse antes de utilizarlo para tomar decisiones sensibles.
¿Cuál es la diferencia entre un embedding y un vector?
Un vector es una secuencia ordenada de números que puede utilizarse para representar muchas magnitudes matemáticas. Un embedding, en cambio, es una representación aprendida por un modelo para describir determinadas propiedades o relaciones de un elemento. Por eso, aunque los embeddings suelen expresarse como vectores, no cualquier vector constituye un embedding. Además, los valores de representaciones creadas por modelos diferentes no son necesariamente comparables.
¿Qué tipos de embeddings existen?
Se utilizan embeddings de palabras, de frases y documentos, de imágenes y de audio, entre otros. Los modelos multimodales permiten relacionar determinados formatos, por ejemplo buscar fotografías a partir de una descripción escrita. Cada representación está optimizada para ciertas tareas, de modo que elegir un modelo adecuado para el idioma, los datos y la finalidad del proyecto es más importante que utilizar indiscriminadamente el mismo en todos los casos.
¿Qué relación existe entre embeddings y RAG?
En muchas arquitecturas RAG, los embeddings ayudan a encontrar fragmentos de documentos relevantes para una consulta. Después, esos fragmentos se proporcionan a un modelo generativo para elaborar una respuesta basada en ellos. RAG es el flujo completo de recuperación y generación; los embeddings son solo una de las técnicas que pueden utilizarse en la recuperación. Por ello también deben evaluarse la calidad de las fuentes, los permisos de acceso y la fidelidad de la respuesta.