Los modelos de lenguaje de gran tamaño o LLMs se han convertido en una de las tecnologías fundamentales de la inteligencia artificial actual. Son la base de asistentes conversacionales, herramientas de generación de código, sistemas de análisis documental, aplicaciones multimodales y agentes capaces de trabajar con diferentes herramientas y fuentes de información.
Sin embargo, ya no existe un único tipo de LLM ni tiene demasiado sentido hablar simplemente del “mejor modelo”. OpenAI, Anthropic, Google, Meta, DeepSeek, Alibaba, Mistral, Microsoft, IBM y otras compañías mantienen familias completas con modelos orientados a diferentes necesidades: razonamiento, programación, conversación, multimodalidad, velocidad, ejecución local o integración con agentes. Elegir correctamente requiere analizar el caso de uso y no limitarse a utilizar el modelo más conocido. Una Consultoría IA para empresas permite precisamente estudiar qué modelo, arquitectura e integración resultan adecuados para cada proceso.
Esta lista reúne algunas de las familias de LLM más relevantes del ecosistema actual. Aun así, conviene tener presente que el mercado evoluciona muy rápido: aparecen nuevas versiones, modelos especializados y variantes constantemente, por lo que ninguna lista puede mantenerse completamente exhaustiva de forma indefinida.
¿Qué son los modelos de lenguaje de gran tamaño o LLMs?
Un LLM, del inglés Large Language Model, es un modelo de inteligencia artificial entrenado con enormes volúmenes de información para aprender patrones del lenguaje y generar nuevas respuestas. Estos modelos pueden utilizarse para tareas como responder preguntas, resumir documentos, traducir, generar código, mantener conversaciones o participar en sistemas de IA más complejos.
Qué significa LLM
Las siglas LLM hacen referencia a modelos de lenguaje de gran tamaño. El término “gran tamaño” está relacionado con la escala de los modelos, los datos utilizados durante su entrenamiento y, especialmente, con la enorme cantidad de parámetros que pueden incorporar.
Para qué se utilizan los LLM
Sus aplicaciones incluyen conversación, generación y revisión de textos, clasificación de información, traducción, programación, análisis de documentación y razonamiento sobre problemas de varios pasos. Además, cada vez es más habitual utilizarlos como motor de agentes de IA capaces de consultar sistemas externos y ejecutar herramientas.
Por qué existen tantos modelos diferentes
No todos los casos de uso necesitan las mismas capacidades. Algunos modelos priorizan razonamiento avanzado, otros velocidad, otros eficiencia de costes, multimodalidad, privacidad o la posibilidad de ejecutarse en infraestructura propia. Por esta razón, las principales compañías han desarrollado familias enteras con diferentes tamaños y especializaciones.
Lista de los principales modelos de lenguaje de gran tamaño
Para entender mejor el ecosistema resulta más útil analizar los modelos por familias y desarrolladores que intentar crear un ranking absoluto. Cada proveedor sigue una estrategia diferente en términos de rendimiento, apertura, razonamiento, multimodalidad, especialización o coste.
Modelos GPT de OpenAI
La familia GPT ha tenido un papel central en la popularización de la IA generativa. OpenAI ha ido evolucionando desde modelos principalmente conversacionales hacia una familia que combina propósito general, razonamiento, programación y variantes optimizadas para coste y velocidad.
GPT-5
GPT-5 representa la familia general de modelos avanzados de OpenAI. Está orientada a tareas de propósito general y razonamiento, y sirve como base para diferentes variantes según los recursos y el nivel de complejidad necesario.
GPT-5 mini
GPT-5 mini está orientado a cargas de trabajo donde el coste, la velocidad y el volumen tienen especial importancia. Puede resultar adecuado cuando no se necesita utilizar continuamente la variante más potente de la familia.
GPT-5 nano
La variante nano busca reducir todavía más latencia y coste para procesos de alta frecuencia y tareas más acotadas donde la eficiencia operativa resulta prioritaria.
GPT-5 Codex
GPT-5 Codex está especializado en programación y tareas relacionadas con desarrollo de software y código agéntico. Este tipo de modelos busca ir más allá del autocompletado y trabajar dentro de procesos de desarrollo más completos.
GPT-OSS
OpenAI también dispone de modelos de pesos abiertos dentro de la familia GPT-OSS, incluyendo variantes orientadas a propósito general y despliegues con menores requisitos de infraestructura.
Modelos Claude de Anthropic
Claude es la familia de modelos desarrollada por Anthropic. La gama se organiza principalmente alrededor de tres niveles que permiten equilibrar potencia, velocidad y coste según el tipo de tarea.
Claude Haiku
Haiku representa la línea más ligera de Claude y está optimizada para velocidad y eficiencia. Puede utilizarse en procesos de gran volumen donde una respuesta rápida resulta más importante que disponer del máximo nivel de razonamiento.
Claude Sonnet
Sonnet ocupa una posición intermedia y está diseñado para ofrecer un equilibrio entre rendimiento y eficiencia. Es una de las opciones más orientadas a casos de uso empresariales y tareas complejas sin recurrir necesariamente al modelo de mayor tamaño.
Claude Opus
Opus representa la gama de mayor capacidad de Anthropic y está orientada a tareas difíciles, análisis extensos y procesos que requieren un mayor nivel de razonamiento.
Modelos Gemini de Google
Gemini es la familia de modelos desarrollada por Google DeepMind. La gama combina razonamiento, multimodalidad y diferentes niveles de velocidad y coste.
Gemini Pro
Gemini Pro representa la línea de mayor capacidad y está orientada a tareas que requieren razonamiento, manejo de contextos complejos y procesamiento multimodal.
Gemini Flash
Flash prioriza velocidad y eficiencia, manteniendo capacidades avanzadas pero optimizando la ejecución para aplicaciones donde la latencia tiene un peso importante.
Gemini Flash-Lite
Flash-Lite está pensado para tareas de alto volumen y costes ajustados, como traducción, clasificación y determinados procesos de uso de herramientas.
Modelos Grok de xAI
Grok es la familia desarrollada por xAI. A lo largo de sus distintas generaciones ha incorporado modelos generales, de razonamiento, variantes rápidas y versiones especializadas en programación.
Grok 4
Grok 4 pertenece a la cuarta generación de la familia y está orientado al uso general con capacidades de razonamiento y diferentes modalidades de entrada.
Grok 4 Heavy
La variante Heavy está orientada a cargas de mayor complejidad, priorizando capacidad frente a eficiencia.
Grok 4 Fast
Grok 4 Fast representa una variante optimizada para reducir tiempos de respuesta y mejorar la eficiencia en tareas menos exigentes.
Grok 4.1
Grok 4.1 continúa la evolución de la cuarta generación e incorpora configuraciones orientadas tanto al uso convencional como a procesos de razonamiento.
Grok Code Fast
Grok Code Fast está especializado en programación y procesos de codificación agéntica, priorizando la eficiencia en tareas relacionadas con software.
Modelos de lenguaje abiertos y de pesos abiertos
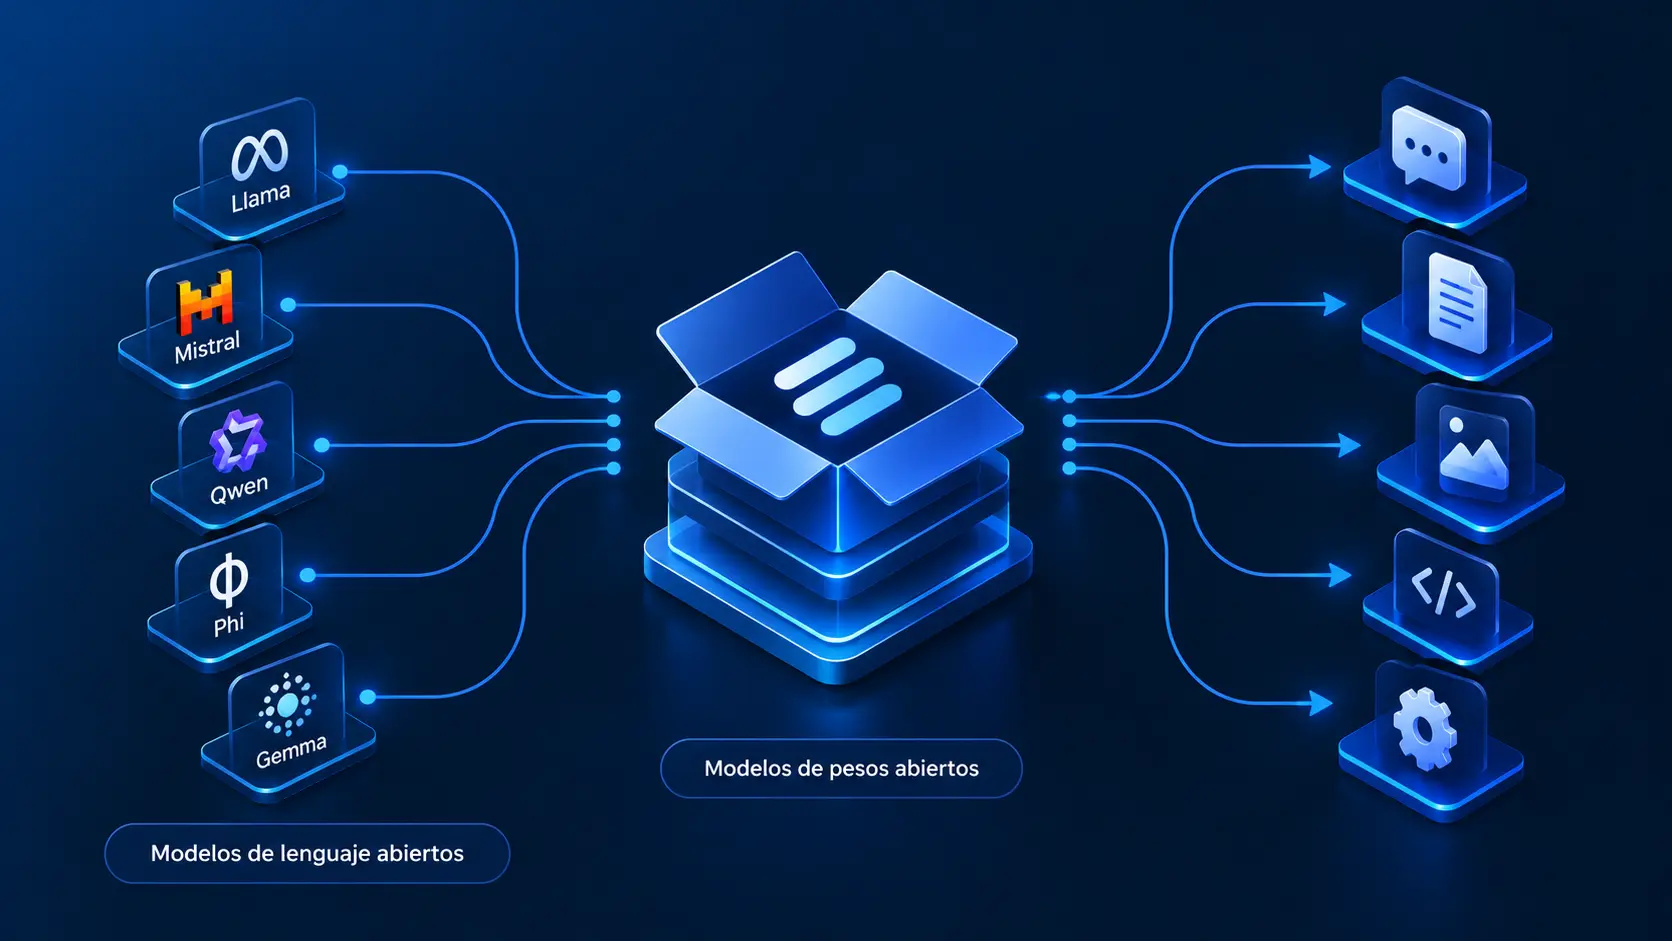
Una parte fundamental del ecosistema LLM está formada por modelos que permiten descargar sus pesos y ejecutarlos en infraestructura propia. Sin embargo, conviene distinguir entre código abierto y pesos abiertos, porque no significan exactamente lo mismo.
Qué significa modelo de código abierto
Un modelo realmente abierto proporciona un nivel elevado de acceso al código, pesos y procedimientos necesarios para estudiar, modificar y utilizar el sistema bajo una licencia compatible.
Qué significa modelo de pesos abiertos
Los modelos de pesos abiertos permiten descargar los parámetros entrenados y ejecutar o ajustar el modelo, aunque no necesariamente proporcionan acceso completo al código de entrenamiento, los conjuntos de datos o todos los detalles necesarios para reproducirlo.
Por qué no son exactamente lo mismo
Un modelo puede distribuir sus pesos y seguir imponiendo restricciones de licencia. Por este motivo, hablar de “modelo abierto” suele ser más preciso que utilizar automáticamente “open source” para cualquier modelo descargable.
Modelos Llama de Meta
Llama ha sido una de las familias más influyentes en la expansión de los modelos descargables y personalizables. Sus diferentes generaciones han incorporado tamaños, capacidades multimodales y arquitecturas cada vez más avanzadas.
Llama 3
Llama 3 supuso una evolución importante de la familia y estuvo disponible en diferentes tamaños para adaptarse a distintas capacidades de infraestructura.
Llama 3.1, 3.2 y 3.3
Las versiones posteriores ampliaron contexto, tamaños y capacidades. Llama 3.2 incorporó variantes pequeñas y capacidades de visión, mientras que 3.3 optimizó el rendimiento con un modelo de menor tamaño que versiones anteriores de gran escala.
Llama 4 Scout
Scout forma parte de la cuarta generación y utiliza una arquitectura de mezcla de expertos, combinando multimodalidad y un número de parámetros activos inferior al total disponible.
Llama 4 Maverick
Maverick representa otra de las variantes principales de Llama 4 y utiliza también una arquitectura MoE para combinar gran capacidad con una ejecución más eficiente.
Modelos DeepSeek
DeepSeek ha adquirido una gran relevancia dentro del ecosistema abierto por combinar modelos de gran escala, arquitecturas MoE y modelos especializados en razonamiento.
DeepSeek-V3
DeepSeek-V3 utiliza una arquitectura de mezcla de expertos con un número muy elevado de parámetros totales, aunque solo una parte se activa durante cada inferencia. Esto permite combinar escala y eficiencia.
DeepSeek-R1
R1 está especialmente orientado al razonamiento y se convirtió en una referencia dentro de los modelos abiertos para problemas complejos y tareas que requieren varios pasos.
DeepSeek-V3.1 y V3.2
Las versiones posteriores evolucionaron hacia un enfoque híbrido capaz de combinar inferencia convencional y razonamiento dentro de un mismo modelo.
DeepSeek-R1-Distill
Las variantes R1-Distill utilizan modelos más pequeños de otras familias y técnicas de destilación para aproximarse al comportamiento de razonamiento de R1 con menores requisitos de infraestructura.
Modelos Qwen de Alibaba
Qwen se ha convertido en una de las familias abiertas con mayor variedad de tamaños, arquitecturas y capacidades. Dispone de modelos generales, multimodales, de código y variantes orientadas a razonamiento.
Qwen3
Qwen3 incluye diferentes tamaños, desde modelos relativamente pequeños hasta grandes modelos MoE. Existen variantes básicas, de instrucciones y orientadas a razonamiento.
Qwen3-Next
Qwen3-Next experimenta con arquitecturas de atención alternativas para reducir la cantidad de parámetros activos y mejorar la eficiencia.
Qwen3-Omni
Qwen3-Omni incorpora capacidades multimodales nativas y puede trabajar con texto, imagen, audio y vídeo como entrada.
Qwen3-Coder
Las variantes Coder están especializadas en generación y trabajo con código, lo que las hace especialmente interesantes para herramientas de programación y agentes de desarrollo.
Qwen3.5
Qwen3.5 amplía la familia con modelos multimodales y diferentes tamaños, incluyendo opciones densas y arquitecturas de mezcla de expertos orientadas a competir en tareas avanzadas de razonamiento.
Modelos Mistral
Mistral AI mantiene una oferta mixta de modelos propietarios y abiertos, con variantes generales, pequeñas y especializadas en programación.
Mistral Large
Mistral Large representa la gama de modelos generales de mayor escala de la compañía y utiliza arquitecturas orientadas a competir en tareas complejas.
Mistral Small
Mistral Small busca ofrecer un equilibrio entre tamaño, eficiencia y rendimiento para despliegues con menores requisitos.
Ministral
Ministral es la línea de modelos pequeños de Mistral, disponible en diferentes tamaños y configuraciones para tareas generales o de razonamiento.
Codestral
Codestral está especializado en programación y finalización de código, convirtiéndose en una opción orientada específicamente a herramientas para desarrolladores.
Devstral
Devstral está especialmente orientado a ingeniería agéntica y tareas donde el modelo necesita trabajar con código y herramientas dentro de procesos de varios pasos.
Mixtral
Mixtral fue una de las familias que ayudaron a popularizar la arquitectura de mezcla de expertos dentro del ecosistema de modelos abiertos.
Modelos Gemma de Google
Gemma 3
Gemma 3 es la familia abierta de Google y dispone de variantes en diferentes tamaños, incluyendo modelos capaces de procesar texto e imágenes y trabajar en numerosos idiomas.
Gemma 3n
Gemma 3n utiliza una arquitectura experimental orientada a conseguir modelos eficientes y adaptables a dispositivos y entornos con recursos limitados.
FunctionGemma
FunctionGemma es una variante pequeña específicamente ajustada para llamada de funciones y uso de herramientas, una capacidad relevante para agentes de IA.
Modelos Granite de IBM
Granite es la familia de modelos de IBM y está especialmente orientada a aplicaciones empresariales, con un fuerte foco en eficiencia y modelos de tamaños relativamente contenidos.
Granite 4-H Small
Granite 4-H Small utiliza una arquitectura híbrida y de mezcla de expertos para combinar capacidad con eficiencia durante la inferencia.
Granite 4-H Tiny
Tiny reduce todavía más los requisitos y está orientado a aplicaciones que necesitan modelos pequeños sin renunciar a capacidades generales.
Granite 4-H Micro
Micro representa otra variante compacta pensada para aplicaciones donde los recursos disponibles condicionan la elección del modelo.
Granite 4 Nano
Granite 4 Nano agrupa modelos todavía más pequeños, adecuados para determinados casos de uso locales o sistemas donde la eficiencia y el consumo de memoria son especialmente importantes.
Modelos Phi de Microsoft
Phi es la familia de modelos pequeños de Microsoft. Su filosofía muestra que un modelo de menor tamaño puede resultar suficiente para muchos casos de uso cuando el objetivo está correctamente definido.
Phi-4
Phi-4 es un modelo orientado exclusivamente a texto y representa una de las principales versiones generales de la familia.
Phi-4 mini
Phi-4 mini reduce significativamente el tamaño para facilitar su ejecución en entornos donde recursos, coste y latencia son prioritarios.
Phi-4 multimodal
La variante multimodal incorpora capacidad para procesar texto, imágenes y voz dentro de un mismo sistema.
Phi-4 Reasoning Vision
Esta variante combina razonamiento y comprensión multimodal para trabajar con información visual, texto y documentos.
Modelos Cohere
Command R y Command R+
Command R fue diseñado con especial atención a casos empresariales, RAG y uso de herramientas. Command R+ amplió esta propuesta con un modelo de mayor capacidad.
Command A
Command A continúa la línea empresarial de Cohere e incorpora variantes orientadas a razonamiento, traducción y visión.
Aya
Aya es la familia de Cohere orientada especialmente al multilingüismo y cuenta con modelos capaces de trabajar con un número elevado de idiomas.
Tiny Aya
Tiny Aya lleva este enfoque multilingüe a modelos mucho más ligeros, incluyendo variantes optimizadas para diferentes regiones lingüísticas.
Modelos Kimi de Moonshot AI
Kimi K2
Kimi K2 es un modelo MoE de gran escala orientado principalmente a texto y capaz de competir en tareas complejas de programación y razonamiento.
Kimi K2 Thinking
K2 Thinking es la variante específicamente orientada a razonamiento y resolución de tareas que requieren procesos más largos y estructurados.
Kimi K2.5
Kimi K2.5 amplía la familia incorporando capacidades de visión multimodal y diferentes modos adaptados a distintas cargas de trabajo.
Modelos GLM de Z.ai
GLM-4.5
GLM-4.5 utiliza una arquitectura MoE de gran escala y dispone de variantes de diferentes tamaños, además de versiones con capacidades visuales.
GLM-4.6
GLM-4.6 continuó la evolución de esta familia e incorporó versiones de visión y variantes más ligeras.
GLM-4.7
GLM-4.7 introdujo nuevas optimizaciones y una variante Flash con menor número de parámetros activos.
GLM-5
GLM-5 representa una evolución significativa en escala dentro de la familia y utiliza también una arquitectura orientada a activar únicamente una parte de sus parámetros durante la inferencia.
Modelos MiniMax
MiniMax-M1
MiniMax-M1 es un modelo de razonamiento de gran escala basado en una arquitectura MoE.
MiniMax-M2
MiniMax-M2 busca mejorar el equilibrio entre capacidad y eficiencia activando una parte relativamente pequeña de sus parámetros durante cada token.
MiniMax-M2.5
M2.5 evoluciona el rendimiento de esta familia y dispone también de una variante Lightning enfocada en acelerar la generación.
MiniMax-M2.7
M2.7 continúa la evolución de la serie M2 con nuevas mejoras sobre las versiones anteriores.
Modelos Nemotron de NVIDIA
Nemotron Nano
NVIDIA dispone de variantes Nemotron Nano que combinan arquitecturas híbridas con modelos relativamente pequeños capaces de trabajar tanto con inferencia convencional como con razonamiento.
Nemotron 3 Nano
Nemotron 3 Nano incluye modelos de distintos tamaños, entre ellos arquitecturas MoE que mantienen un número reducido de parámetros activos durante la inferencia.
Nemotron 3 Super
Nemotron 3 Super aumenta la escala de la familia utilizando también una arquitectura de mezcla de expertos.
Modelos Falcon
Falcon-H1
Falcon-H1 engloba diferentes tamaños y combina arquitecturas híbridas para conseguir modelos más eficientes.
Falcon-H1R
Falcon-H1R es una variante especialmente orientada a razonamiento.
Falcon-H1-Tiny
La familia Tiny lleva Falcon a modelos extremadamente pequeños y especializados para aplicaciones concretas.
Falcon-Edge
Falcon-Edge experimenta con modelos de muy baja precisión de bits orientados a reducir consumo de memoria y facilitar despliegues en dispositivos con recursos limitados.
Modelos Olmo de Ai2
Olmo 3
Olmo destaca por un enfoque especialmente abierto, con acceso a código, pesos, checkpoints y conjuntos de datos en numerosas versiones. Olmo 3 incluye modelos densos de diferentes tamaños.
Olmo 3.1
Olmo 3.1 actualiza las capacidades de la versión de mayor tamaño de esta generación.
Olmo Hybrid
Olmo Hybrid experimenta con una arquitectura híbrida que combina Transformers con redes neuronales lineales.
Tabla comparativa de los principales LLM
¿Cuáles son los mejores LLM según el caso de uso?
No existe un modelo universalmente mejor. Un LLM puede ser excelente para razonamiento y resultar innecesariamente costoso para clasificación sencilla, mientras que un modelo pequeño puede funcionar perfectamente para miles de operaciones repetitivas. La elección debe hacerse según el problema concreto.
Mejores LLM para conversación
Familias generalistas como GPT, Claude, Gemini o Grok están orientadas a mantener conversaciones complejas, seguir instrucciones y trabajar con grandes cantidades de contexto.
Mejores LLM para razonamiento
Claude Opus y Sonnet, Gemini Pro, GPT, DeepSeek-R1, Qwen y diferentes modelos especializados destacan por incorporar modos o versiones orientadas a resolver tareas complejas de varios pasos.
Mejores LLM para programación
GPT Codex, Codestral, Devstral, Qwen Coder y Grok Code Fast son ejemplos de modelos o variantes específicamente orientadas a programación y tareas agénticas relacionadas con desarrollo.
Mejores LLM para trabajar con documentos
Las familias capaces de trabajar con contextos amplios y entradas multimodales resultan especialmente útiles para analizar documentación, informes, imágenes y otros archivos dentro de una misma interacción.
Mejores LLM multimodales
Gemini, Claude, GPT, Llama, Qwen, Kimi, Gemma y determinadas variantes Phi permiten combinar texto con otras modalidades como imagen, audio o vídeo.
Mejores LLM abiertos
DeepSeek, Qwen, Granite, Olmo y determinadas familias de Mistral forman parte de las opciones especialmente relevantes cuando se busca un mayor nivel de apertura y control sobre la infraestructura.
Mejores LLM para ejecución local
Modelos pequeños de Gemma, Phi, Granite, Falcon, Qwen o Ministral pueden ser especialmente interesantes cuando se quiere reducir dependencia de servicios cloud o ejecutar la inferencia en hardware propio.
Mejores LLM para empresas
La elección empresarial depende de seguridad, integración, coste, rendimiento, datos y soporte. Claude, GPT, Gemini, Command, Granite, Mistral y diferentes modelos abiertos pueden ser adecuados en función del escenario.
Mejores LLM para agentes de IA
Un modelo adecuado para agentes necesita algo más que generar buen texto. Resultan especialmente importantes el razonamiento, el uso de herramientas, la capacidad de seguir instrucciones y la estabilidad en procesos de varios pasos.
Modelos grandes vs modelos pequeños: ¿cuál elegir?
Large Language Models o LLM
Los modelos grandes suelen disponer de mayor capacidad para resolver tareas variadas y complejas, pero también requieren más recursos y pueden generar un coste superior durante la inferencia.
Small Language Models o SLM
Los modelos pequeños sacrifican parte de la capacidad general a cambio de velocidad, coste y facilidad de despliegue. Cuando la tarea está bien delimitada pueden resultar más eficientes que recurrir constantemente a un modelo de frontera.
Cuándo interesa ejecutar un modelo localmente
La ejecución local puede resultar interesante cuando existen requisitos de privacidad, latencia, conectividad o control de infraestructura. También puede ser adecuada para cargas muy repetitivas donde disponer de hardware propio resulta económicamente competitivo.
Por qué un modelo más grande no siempre es mejor
Utilizar más capacidad de la necesaria incrementa costes y latencia sin garantizar una mejora proporcional. La arquitectura más eficiente es aquella que utiliza el modelo adecuado para cada tarea.
Modelos propietarios vs modelos abiertos
Ventajas de un LLM propietario
Los modelos propietarios simplifican la infraestructura y permiten utilizar capacidades avanzadas mediante APIs sin tener que gestionar directamente el despliegue y mantenimiento del modelo.
Ventajas de un modelo abierto
Los modelos abiertos pueden ofrecer mayor control sobre despliegue, personalización y tratamiento de los datos, especialmente cuando se ejecutan en infraestructura propia.
Qué opción tiene más sentido para una empresa
La respuesta depende de factores como sensibilidad de los datos, capacidad técnica interna, volumen de uso, necesidades de personalización y coste. Muchas arquitecturas empresariales pueden incluso combinar modelos propietarios y modelos abiertos en diferentes procesos.
Cómo elegir un modelo de lenguaje para una empresa
Calidad y precisión
El modelo debe evaluarse con tareas reales del negocio. Un benchmark general no sustituye a pruebas realizadas con documentación, instrucciones y casos representativos del entorno en el que se utilizará.
Coste por uso
En aplicaciones de gran volumen, pequeñas diferencias de coste por inferencia pueden tener un impacto importante. El modelo debe dimensionarse según el valor de la tarea que realiza.
Velocidad y latencia
Un asistente conversacional, un agente en tiempo real y un proceso ejecutado durante la noche pueden admitir tiempos de respuesta muy diferentes. La latencia debe evaluarse dentro del proceso completo.
Ventana de contexto
Cuando se trabaja con documentación extensa, conversaciones prolongadas o grandes bases de código, la cantidad de contexto que puede procesar el modelo adquiere especial importancia.
Multimodalidad
Si el proceso incluye documentos visuales, fotografías, audio o vídeo, conviene valorar modelos que puedan procesar directamente esas modalidades.
Uso de herramientas
Para construir agentes no basta con generar buenas respuestas. El modelo debe interactuar de forma fiable con funciones, APIs y herramientas externas.
Privacidad de los datos
La sensibilidad de la información puede condicionar la elección del proveedor, el tipo de infraestructura y la posibilidad de ejecutar el modelo de forma local.
Posibilidad de despliegue local
Los modelos descargables permiten desplegar la inferencia en servidores propios o infraestructuras privadas, siempre que la empresa disponga de recursos suficientes para operarlos.
Integración con ERP y CRM
El modelo genera verdadero valor empresarial cuando puede trabajar con el contexto de los sistemas utilizados por la organización. La integración con ERP, CRM, bases de datos y otras aplicaciones permite pasar de un chatbot genérico a sistemas adaptados al negocio.
El modelo genera verdadero valor empresarial cuando puede trabajar con el contexto de los sistemas utilizados por la organización. La integración con ERP, CRM, bases de datos y otras aplicaciones permite pasar de un chatbot genérico a sistemas adaptados al negocio.
LLM y agentes de IA
Qué papel desempeña el modelo dentro de un agente
El LLM puede actuar como motor de interpretación y razonamiento. Recibe el objetivo, analiza el contexto y participa en la decisión sobre qué acciones debe ejecutar el sistema.
Uso de herramientas
Los agentes amplían las capacidades del modelo mediante herramientas. De esta forma pueden consultar bases de datos, acceder a aplicaciones o ejecutar acciones que un LLM aislado no podría completar.
Model Context Protocol
Model Context Protocol permite estandarizar parte de la conexión entre aplicaciones de IA y herramientas externas. Esto facilita crear arquitecturas en las que distintos modelos puedan trabajar con fuentes y sistemas empresariales.
¿Todos los LLM sirven para agentes?
No todos ofrecen el mismo rendimiento. Para tareas agénticas conviene valorar razonamiento, seguimiento de instrucciones, estabilidad, capacidad de uso de herramientas, coste y velocidad. Puedes profundizar en este tipo de sistemas en nuestro artículo sobre qué es la IA agéntica y cómo funciona.
¿Qué modelo LLM debería utilizar mi empresa?
No existe una respuesta universal. El modelo adecuado depende del proceso que se quiera mejorar, los datos utilizados, el nivel de precisión necesario, el volumen de ejecuciones y las restricciones de seguridad y presupuesto.
Una empresa puede necesitar un modelo avanzado para analizar documentación compleja, otro mucho más pequeño para clasificar miles de registros y un tercero especializado en programación para apoyar a su equipo técnico. Incluso dentro de un mismo agente pueden utilizarse diferentes modelos según la dificultad de cada tarea.
En Process Control analizamos el proceso antes de seleccionar la tecnología. A través de nuestra consultoría e implementación de Inteligencia Artificial para empresas podemos evaluar modelos, costes, arquitectura e integraciones con ERP, CRM, bases de datos y otras aplicaciones para determinar qué alternativa encaja realmente con cada caso de uso.
Preguntas frecuentes sobre los modelos de lenguaje de gran tamaño
¿Cuáles son los principales modelos LLM?
Entre las principales familias se encuentran GPT, Claude, Gemini, Grok, Llama, DeepSeek, Qwen, Mistral, Gemma, Granite, Phi, Cohere Command, Kimi, GLM, MiniMax, Nemotron, Falcon y Olmo.
¿Cuál es el LLM más utilizado?
No existe una única respuesta válida para todos los entornos. El nivel de uso cambia entre productos comerciales, APIs, investigación, modelos descargados y despliegues empresariales.
¿Cuál es el mejor LLM?
El mejor LLM depende del caso de uso. Un modelo puede destacar en razonamiento, otro en velocidad, otro en programación y otro resultar más adecuado para ejecutar de forma local.
¿ChatGPT es un LLM?
ChatGPT es una aplicación construida sobre modelos de inteligencia artificial. Conviene diferenciar entre el producto con el que interactúa el usuario y los modelos GPT que utiliza.
¿Claude es un LLM?
Claude es una familia de modelos de lenguaje desarrollada por Anthropic y dividida principalmente en las gamas Haiku, Sonnet y Opus.
¿Gemini es un LLM?
Gemini es una familia de modelos de Google DeepMind con capacidades de lenguaje, razonamiento y procesamiento multimodal.
¿DeepSeek es un LLM?
DeepSeek desarrolla diferentes LLM, entre ellos modelos generales como V3 y modelos especialmente orientados a razonamiento como R1.
¿Qué LLM son de código abierto?
DeepSeek, Granite y Olmo son ejemplos relevantes dentro del ecosistema abierto. Otras familias distribuyen sus pesos pero utilizan licencias propias, por lo que conviene revisar cada modelo antes de considerarlo estrictamente de código abierto.
¿Cuál es la diferencia entre LLM abierto y propietario?
Un modelo propietario se utiliza normalmente mediante el servicio del proveedor, mientras que un modelo abierto o de pesos abiertos puede permitir mayor control sobre la ejecución, adaptación y despliegue, dependiendo de su licencia.
¿Qué LLM puede ejecutarse localmente?
Numerosos modelos descargables de familias como Gemma, Phi, Qwen, Mistral, Granite, Llama, Falcon o DeepSeek pueden ejecutarse localmente si el hardware disponible cumple sus requisitos.
¿Qué modelo es mejor para programar?
Existen variantes específicamente orientadas a código como GPT Codex, Codestral, Devstral, Qwen Coder o Grok Code Fast. La mejor elección depende del lenguaje, herramientas, presupuesto y tipo de flujo de desarrollo.
¿Qué LLM es mejor para empresas?
No existe un único modelo empresarial ideal. Deben evaluarse calidad, seguridad, coste, latencia, integración, soporte, privacidad y requisitos de infraestructura.
¿Un modelo más grande siempre es mejor?
No. Los modelos pequeños pueden ser más rápidos y económicos y ofrecer suficiente calidad para muchas tareas concretas. Elegir un modelo excesivamente grande puede incrementar costes sin aportar una mejora proporcional.
¿Los LLM pueden utilizar herramientas?
Sí. Muchos modelos actuales pueden utilizar funciones y herramientas externas cuando se integran dentro de una aplicación preparada para ello.
¿Qué LLM se utiliza para agentes de IA?
Pueden utilizarse diferentes familias. Lo importante es que el modelo disponga de suficiente capacidad de razonamiento, seguimiento de instrucciones y uso de herramientas para el proceso que debe ejecutar el agente.