La visión por computador es una disciplina de la inteligencia artificial que permite a los sistemas informáticos analizar imágenes y vídeos para reconocer elementos, identificar patrones y extraer información útil. En lugar de limitarse a almacenar una fotografía o reproducir una grabación, el sistema interpreta sus características visuales para responder a preguntas concretas: ¿hay un defecto en esta pieza?, ¿cuántas cajas han atravesado la cinta transportadora?, ¿qué información aparece en una factura escaneada? El valor no reside solo en detectar lo que muestra una imagen, sino en convertir esa observación en una decisión que pueda utilizar una persona o un proceso empresarial.
La tecnología lleva décadas evolucionando, pero los avances del machine learning y el deep learning han ampliado notablemente sus aplicaciones. Hoy puede participar en la inspección de productos industriales, la gestión de almacenes, el análisis de imágenes médicas o la automatización documental. Su uso, sin embargo, requiere una combinación de datos representativos, modelos bien evaluados, infraestructura y controles que permitan gestionar errores y accesos. Desde una perspectiva empresarial, una estrategia de consultoría de IA para empresas ayuda a determinar qué procesos visuales justifican realmente desarrollar un sistema y cómo integrarlo con las herramientas que ya utiliza la organización.
Entender qué es la visión por computador, cómo funciona y qué limitaciones presenta permite distinguir una demostración tecnológica llamativa de una solución operativa capaz de aportar resultados sostenibles. A continuación analizamos las técnicas principales, las arquitecturas que se emplean y los casos de uso que tienen más sentido en entornos empresariales.
¿Qué es la visión por computador y para qué sirve?
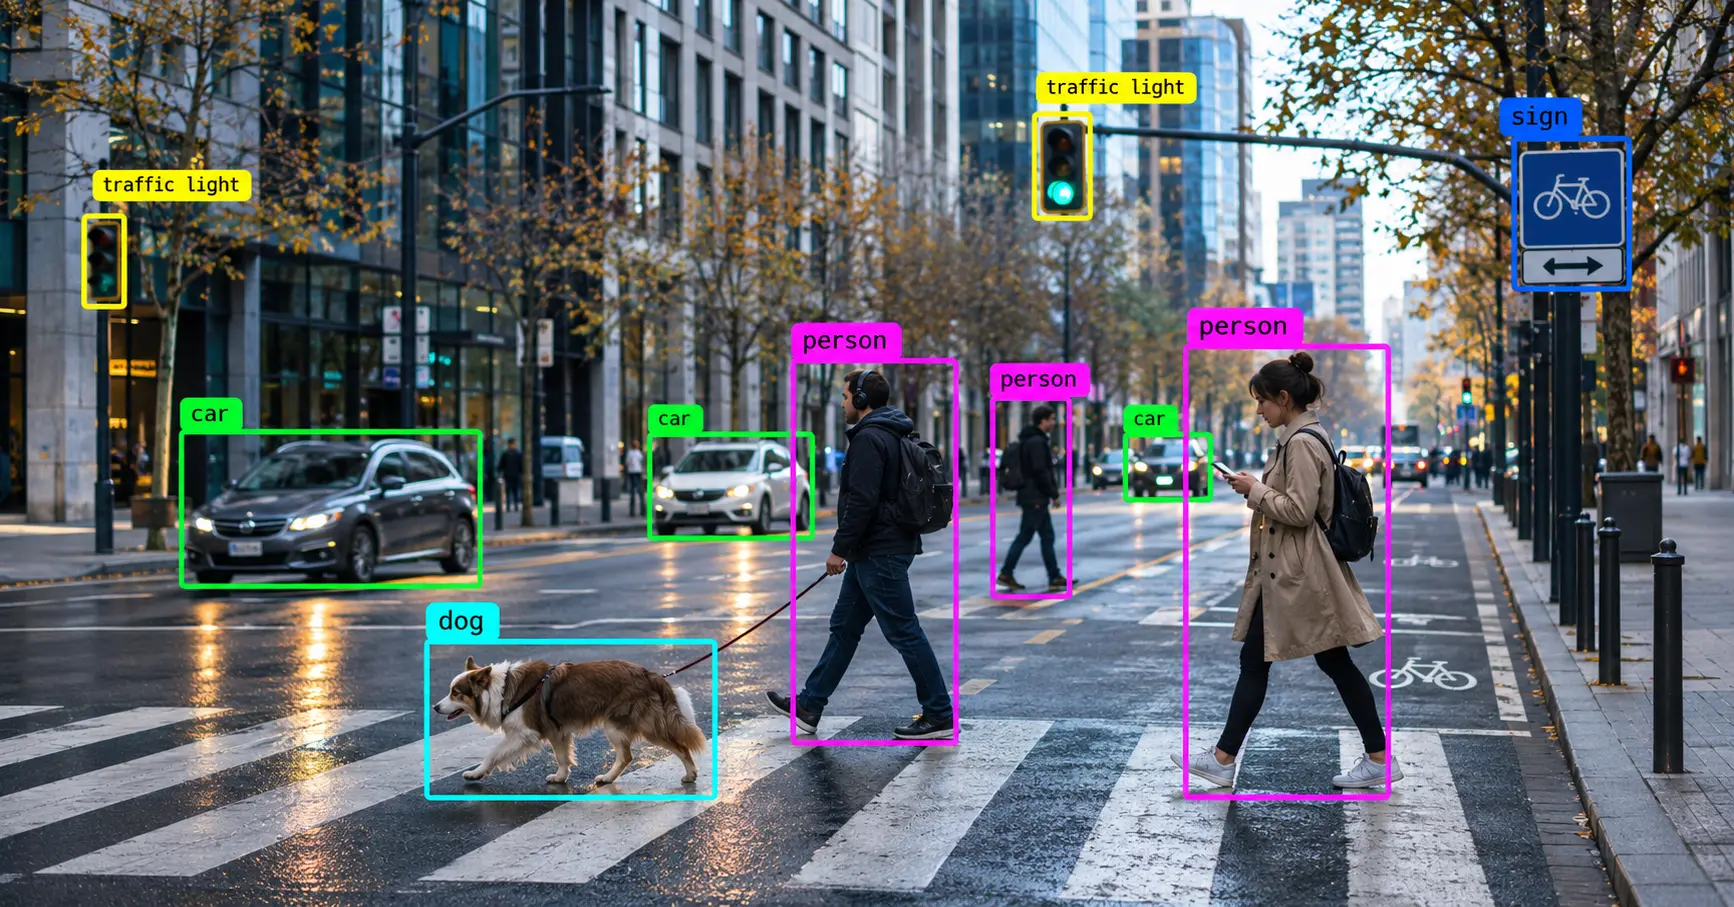
La visión por computador, también conocida como computer vision, estudia cómo conseguir que una máquina obtenga información significativa a partir de datos visuales. Una cámara convencional registra una escena, pero no sabe por sí misma si una pieza está correctamente montada, si un pallet contiene el número esperado de bultos o si la etiqueta de un producto coincide con su referencia. Un sistema de visión por computador añade el procesamiento y la interpretación necesarios para dar respuesta a esas cuestiones. Según el problema, puede limitarse a clasificar una imagen o realizar tareas mucho más complejas, como localizar múltiples objetos y seguir sus movimientos a través de una secuencia de vídeo.
Conviene aclarar la terminología. En muchos contenidos especializados, visión por computador y visión artificial se utilizan como equivalentes. No obstante, en determinados entornos industriales se emplea «visión artificial» para referirse específicamente a sistemas de inspección compuestos por cámaras, óptica, iluminación, software y mecanismos de control de una máquina. «Visión por computador» suele designar el campo informático más amplio de análisis e interpretación visual. La frontera no es universal: ambos términos comparten técnicas y aplicaciones, y la elección depende con frecuencia del sector en que se utilicen.
Tampoco debe confundirse con el procesamiento de imágenes. Este último transforma o mejora la información visual: corrige contraste, reduce ruido, cambia la resolución o separa regiones. La visión por computador puede utilizar esas operaciones como preparación, pero da un paso adicional al inferir qué aparece en la imagen y qué significa para una tarea. Por ejemplo, ajustar la luminosidad de una fotografía es procesamiento de imágenes; identificar una soldadura defectuosa dentro de ella es una aplicación de visión por computador. No todos los sistemas recurren a redes neuronales: ciertas inspecciones de geometría estable pueden resolverse con umbrales, filtros y reglas tradicionales, mientras que las escenas variables suelen beneficiarse de modelos entrenados con datos.
La utilidad práctica depende de vincular cada resultado visual con una necesidad operativa. Un supermercado puede contar productos en una estantería, una empresa logística puede leer códigos y verificar embalajes y una planta de fabricación puede detener una línea cuando detecta una anomalía relevante. La imagen se convierte así en una fuente estructurada de información, que puede registrarse en una aplicación, enviarse al personal responsable o combinarse con datos de un ERP. Ese último paso, que conecta la percepción con la actuación, suele determinar si el proyecto genera valor.
¿Cómo funciona la visión por computador?
Un sistema de visión por computador transforma datos visuales sin interpretar en resultados utilizables. Aunque la arquitectura varía según la aplicación, suele seguir una secuencia común: captar imágenes, prepararlas, analizar sus características, obtener una predicción y utilizarla para apoyar una decisión. En proyectos reales es importante pensar en todo el circuito y no únicamente en el modelo: una cámara mal situada, una iluminación inestable o un dato que llega con retraso pueden comprometer el sistema aunque el algoritmo funcione correctamente en pruebas.
Captura, procesamiento y preparación de imágenes
La primera etapa consiste en obtener imágenes o vídeo desde cámaras industriales, dispositivos móviles, escáneres, drones, sensores de profundidad o repositorios documentales. La calidad de la captura debe adaptarse al objetivo. Para comprobar el color de una etiqueta puede ser decisiva una iluminación controlada; para localizar una grieta diminuta quizá sea necesaria una óptica de mayor resolución; para analizar una cinta transportadora rápida importa tanto la frecuencia de captura como el tiempo de exposición. Elegir la fuente visual adecuada evita intentar corregir posteriormente información que nunca llegó a registrarse.
Después se aplica un preprocesamiento proporcional al problema. Pueden corregirse deformaciones de perspectiva, estabilizar fotogramas, ajustar escalas, eliminar ruido o recortar una zona de interés. En inspección industrial también se utilizan calibraciones para relacionar medidas en píxeles con dimensiones físicas. Estos pasos permiten que el modelo reciba entradas comparables y reducen variaciones irrelevantes. No obstante, mejorar visualmente una imagen no garantiza que mejore el reconocimiento; ciertas transformaciones pueden borrar detalles útiles o alterar la apariencia de defectos. Por ello, conviene evaluar el preprocesamiento junto con el modelo y con imágenes obtenidas en las condiciones de trabajo reales.
La preparación de datos incluye además su organización, revisión y, cuando corresponde, etiquetado. Si se quiere identificar un tipo de anomalía, el conjunto de entrenamiento debería contener ejemplos variados de piezas conformes y defectuosas, capturados en distintas condiciones relevantes. Un sistema que solo ha visto superficies limpias y uniformes puede fallar cuando aparecen reflejos, desgaste, suciedad o productos de un nuevo proveedor. La representatividad de los datos es tan importante como la cantidad, porque determina hasta qué punto el aprendizaje puede generalizarse a imágenes que el modelo no ha visto antes.
Entrenamiento de modelos y reconocimiento de patrones visuales
Con los datos preparados se selecciona el enfoque técnico. Las redes neuronales convolucionales o CNN aprenden características visuales a través de filtros que detectan patrones locales y los combinan en representaciones progresivamente más complejas. Por otra parte, los Vision Transformers (ViT) dividen la imagen en regiones o parches y utilizan mecanismos de atención para modelar relaciones entre ellos. Ninguna arquitectura es superior en todas las situaciones: los resultados dependen del volumen de datos, la tarea, el hardware, la latencia permitida y las métricas de evaluación. También se utilizan modelos preentrenados que pueden adaptarse a un problema concreto, lo que reduce la necesidad de comenzar desde cero.
Durante el entrenamiento se ajustan parámetros del modelo para disminuir el error en ejemplos conocidos. Después se evalúa con datos separados, idealmente incluyendo imágenes representativas de las condiciones que encontrará en producción. En un proyecto de control de calidad no basta con comunicar un porcentaje general de aciertos: importa medir cuántos defectos pasan inadvertidos, cuántas piezas correctas se rechazan y qué consecuencias tiene cada fallo. En otros escenarios se necesitará medir la precisión de localización, el solapamiento de segmentos o el tiempo de respuesta por fotograma. Una métrica adecuada debe reflejar el impacto de los errores sobre el proceso empresarial, no solo el rendimiento en un conjunto de prueba.
Una vez en funcionamiento, la cámara envía nuevas imágenes y el modelo devuelve categorías, coordenadas, máscaras de segmentación, texto reconocido u otras señales. Esas salidas pueden alimentar un panel de supervisión, abrir una incidencia, comprobar una orden de fabricación o pedir revisión humana. El ciclo no termina con el despliegue: los cambios de iluminación, maquinaria, referencias, envases o cámaras pueden modificar las imágenes de entrada y degradar la precisión. La supervisión periódica y la revisión de casos fallidos permiten detectar esos cambios antes de que se conviertan en un problema operativo.
Principales técnicas de visión por computador
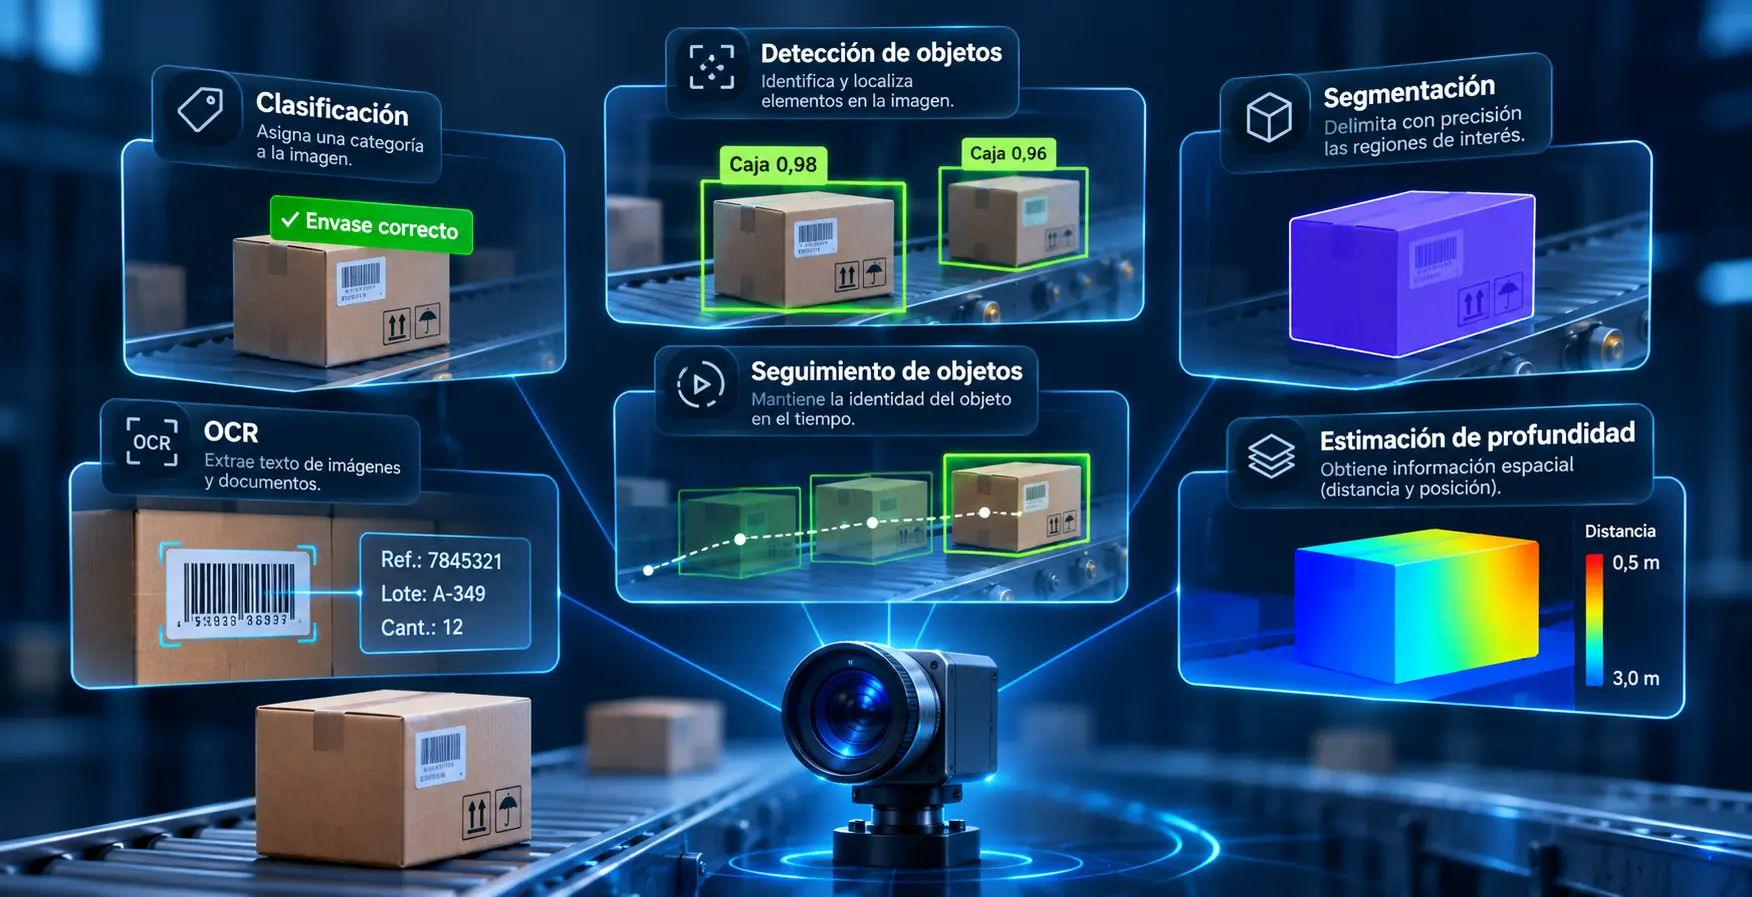
La visión por computador reúne técnicas diferentes que no deben tratarse como si resolvieran la misma pregunta. Una clasificación informa de la categoría general de una imagen, mientras que la detección localiza objetos individuales; la segmentación identifica regiones con mayor detalle y el reconocimiento de caracteres extrae texto. Comprender estas diferencias es esencial para definir correctamente el alcance de un proyecto. Solicitar un modelo que «reconozca productos» sin especificar si debe contarlos, localizarlos, leer sus etiquetas o identificar desperfectos suele conducir a expectativas poco realistas.
Clasificación, detección y seguimiento de objetos
La clasificación de imágenes asigna una categoría a una imagen o región: por ejemplo, «envase correcto», «envase dañado» o «imagen no válida». Es útil cuando el objeto aparece en una posición controlada y la decisión puede expresarse mediante una o varias etiquetas. La detección de objetos, en cambio, identifica la categoría y la posición aproximada de cada elemento mediante recuadros delimitadores. Esto permite contar cajas sobre un transportador, localizar herramientas en una mesa o verificar que todos los componentes esperados estén presentes. Modelos de familias como YOLO y otros detectores modernos se emplean en este tipo de tareas, aunque su conveniencia debe evaluarse para cada entorno y dispositivo.
El seguimiento de objetos añade la dimensión temporal. En lugar de analizar cada fotograma como un caso aislado, intenta mantener la identidad de los elementos mientras se desplazan. Es especialmente útil para conocer recorridos, detectar acumulaciones o medir el paso de unidades por una zona. Un sistema puede, por ejemplo, detectar un paquete, seguirlo durante varios segundos y registrar que cruzó el punto de salida sin contarlo dos veces. Los desafíos aparecen cuando los objetos se ocultan entre sí, cambian de perspectiva o se mueven de forma inesperada; por ello, es importante validar el seguimiento con secuencias reales y no solo con capturas estáticas.
Segmentación de imágenes, reconocimiento OCR y análisis espacial
La segmentación de imágenes permite delimitar regiones a nivel de píxel. A diferencia de un recuadro de detección, una máscara puede describir con más precisión la silueta de un objeto o la extensión de un defecto superficial. Resulta valiosa para comprobar áreas de pintura, estimar superficies dañadas, identificar límites de piezas o asistir en la interpretación de imágenes clínicas. Según la necesidad, se aplica segmentación semántica, que asigna categorías a píxeles, o segmentación de instancias, que diferencia objetos individuales de una misma categoría. La complejidad adicional solo compensa cuando esa precisión espacial resulta necesaria para decidir.
El reconocimiento óptico de caracteres (OCR) se utiliza para obtener texto legible por máquina a partir de fotografías y documentos escaneados. Combinado con otros componentes de análisis documental, ayuda a localizar campos, leer números de serie o comprobar datos de etiquetas. Es importante distinguir entre reconocer caracteres y comprender un documento: extraer un importe no demuestra por sí mismo que sea el total de una factura ni que corresponda al proveedor correcto. Para esos casos se necesitan reglas de validación, reconocimiento de estructura y comprobaciones contra los sistemas de gestión. Del mismo modo, el análisis espacial y la estimación de profundidad pueden incorporar cámaras estereoscópicas, sensores 3D o cálculos geométricos para conocer distancias y posiciones, especialmente en robótica y automatización industrial.
La siguiente tabla resume qué resuelve cada técnica y cuándo tiene sentido utilizarla. En muchos proyectos conviven varias: un sistema de almacén puede detectar una caja, seguir su recorrido y leer después el código impreso en su etiqueta.
Aplicaciones y ejemplos de visión por computador en las empresas
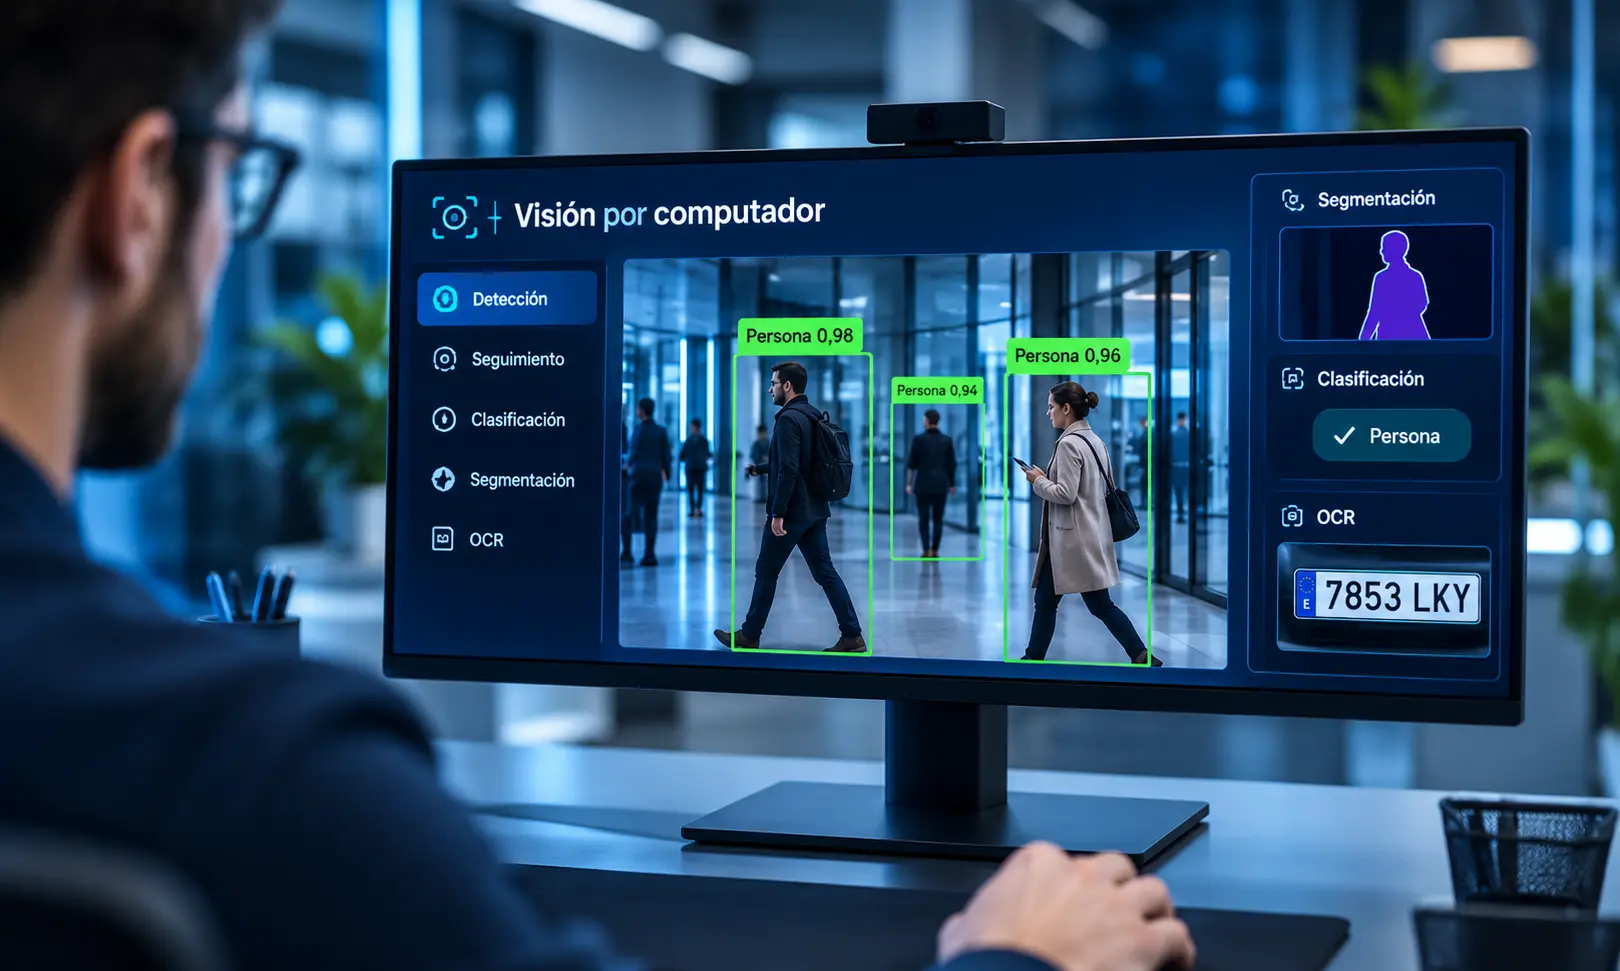
La principal aportación de esta tecnología a una organización es convertir observaciones visuales repetitivas en datos verificables y acciones operativas. No es necesario que todas las empresas desarrollen vehículos autónomos o sistemas avanzados de reconocimiento facial para aprovecharla. A menudo, el retorno más claro aparece en actividades discretas y frecuentes: detectar una etiqueta mal colocada, verificar una referencia antes del envío o registrar automáticamente información que hoy requiere una comprobación manual. La conveniencia depende de la frecuencia de la tarea, las consecuencias del error y la posibilidad de mantener una captura visual consistente.
Industria, fabricación y control de calidad
En una línea de producción, la visión por computador puede revisar dimensiones aparentes, presencia de componentes, estado del embalaje, uniformidad de superficies o defectos visibles. Imaginemos una empresa que fabrica piezas metálicas y debe comprobar que cada unidad incluye dos perforaciones en la posición esperada. Un sistema de cámaras puede identificar la pieza, localizar las perforaciones y marcar aquellas que no cumplen los criterios definidos. Si el error es crítico, la decisión puede activar el desvío de la unidad o solicitar una inspección humana. La tecnología no elimina por sí sola los controles de calidad: hace posible aplicar una revisión repetible y registrar evidencias visuales para su seguimiento.
En estos proyectos, la integración es decisiva. Los resultados pueden asociarse a una orden de trabajo, un lote, una máquina o un turno de fabricación, de modo que el equipo no se limite a recibir una alerta sin contexto. Al vincular los datos visuales con un ERP o una plataforma de operaciones, los responsables pueden analizar defectos recurrentes por referencia o proveedor y decidir si conviene revisar materiales, procesos o calibraciones. Un ejemplo similar se encuentra en el mantenimiento industrial, donde una cámara puede detectar ciertas anomalías visibles, aunque no debe confundirse con técnicas predictivas que necesitan otras señales, como vibración o temperatura.
Logística, comercio, sanidad y otros sectores
En logística, las cámaras pueden reconocer paquetes, detectar embalajes dañados, comprobar ocupación de ubicaciones o leer etiquetas. Para que el dato sea fiable, normalmente debe combinarse con el identificador del pedido o el registro de almacén. Por ejemplo, reconocer un código impreso y contrastarlo con la información de la expedición permite señalar una discrepancia antes de que el paquete abandone la instalación. En el comercio, técnicas similares ayudan a verificar exposición de productos, controlar roturas de stock visibles o automatizar parte del registro de mercancías. El análisis de clientes mediante vídeo exige una evaluación especialmente cuidadosa de privacidad, proporcionalidad y finalidad del tratamiento.
La automatización documental es otra aplicación de interés transversal. Un departamento administrativo puede recibir facturas fotografiadas o albaranes escaneados con formatos diferentes. El OCR extrae el texto; un componente adicional identifica campos relevantes; y unas reglas verifican que importes, referencias y proveedores coincidan con la información del sistema de gestión. Aquí la visión por computador se integra en un proceso mayor: capturar, interpretar, validar y registrar, con revisión humana cuando el documento presenta baja confianza o datos contradictorios. Esta combinación es útil para reducir operaciones manuales sin eliminar los controles contables y documentales necesarios.
En sanidad, la visión por computador puede asistir a profesionales en el análisis de radiografías, resonancias y otras imágenes médicas. Se utiliza para detectar patrones, delimitar estructuras o priorizar imágenes que merecen revisión. Su función y los requisitos regulatorios dependen del propósito concreto del sistema, y la validación clínica resulta imprescindible cuando influye en decisiones sanitarias. En agricultura, drones y cámaras pueden ayudar a identificar síntomas visibles en cultivos o contar frutos; en robótica, la información visual puede contribuir a localizar y recoger objetos; y en movilidad, forma parte de los sistemas que interpretan señales, carriles y obstáculos. Son escenarios muy distintos, pero todos comparten la necesidad de medir la fiabilidad en condiciones reales.
También merece atención su conexión con otras formas de inteligencia artificial. Un sistema puede detectar una incidencia visual y utilizar después un asistente o un flujo de trabajo para elaborar una explicación, recuperar el procedimiento correspondiente y preparar un aviso para el personal. En arquitecturas más avanzadas, esta coordinación puede relacionarse con la IA agéntica y sus casos de uso empresariales. Sin embargo, cualquier agente que actúe sobre sistemas operativos debe trabajar con permisos definidos, validaciones y mecanismos de intervención humana. Detectar una anomalía no autoriza automáticamente a modificar una orden de producción o bloquear una expedición sin las comprobaciones adecuadas.
Ventajas y limitaciones de la visión por computador
Uno de los beneficios más claros es la capacidad de aplicar criterios visuales de forma sistemática y a una frecuencia difícil de sostener mediante revisión manual. Las cámaras pueden recopilar evidencias, los modelos pueden señalar excepciones y los sistemas de gestión pueden conservar trazabilidad sobre lo que ocurrió. Esto facilita controlar tareas repetitivas, disponer de registros comparables y concentrar la revisión humana en casos complejos. En determinados escenarios también permite analizar imágenes en lugares de difícil acceso o responder antes a incidencias, siempre que la captura y la detección sean suficientemente fiables.
La velocidad, sin embargo, no equivale a precisión universal. La visión por computador no interpreta una escena con la misma comprensión general que una persona y puede equivocarse cuando cambian las condiciones respecto al entrenamiento. Un pequeño desplazamiento de cámara, un reflejo sobre una superficie o un embalaje rediseñado pueden afectar al resultado. En proyectos industriales conviene distinguir entre falsos positivos y falsos negativos: rechazar una unidad correcta genera desperdicio o retrabajo; aceptar una unidad defectuosa puede provocar incidencias posteriores. La elección del umbral de decisión debe tener en cuenta ambos costes y, cuando corresponda, establecer revisiones manuales para los casos dudosos.
Otra limitación es la dependencia de los datos y de la infraestructura. Entrenar o adaptar modelos requiere ejemplos pertinentes, etiquetado coherente y criterios de evaluación. El sistema también necesita mantenimiento: actualizaciones, monitorización de desviaciones, pruebas tras modificaciones de la línea y mecanismos de recuperación cuando un componente falla. El coste total incluye cámaras, iluminación, instalación, conectividad, almacenamiento, procesamiento y soporte. Por eso, el modelo con mayor precisión publicada no siempre es la opción más adecuada; un modelo más ligero y estable puede ser preferible si cumple el requisito real con menor latencia y mantenimiento.
Los proyectos que captan imágenes de personas añaden obligaciones en materia de protección de datos y, según el caso, otras normas aplicables. No es lo mismo contar cajas que identificar trabajadores o analizar rostros. El RGPD exige evaluar la base jurídica y las medidas pertinentes cuando se tratan datos personales; determinadas aplicaciones biométricas y sistemas de IA pueden quedar sujetas a requisitos adicionales del Reglamento Europeo de Inteligencia Artificial. El cumplimiento depende de la finalidad y del funcionamiento concreto del sistema, no del mero hecho de utilizar una cámara. La seguridad técnica también importa: los dispositivos, las imágenes y las credenciales de acceso deben protegerse como cualquier otro activo tecnológico conectado a la red empresarial.
¿Cómo implementar la visión por computador en una empresa?
La implementación debería comenzar por un problema concreto y medible. Antes de elegir una librería, conviene describir qué debe observar el sistema, qué decisión se espera y cuánto cuesta actualmente realizar esa tarea. No es lo mismo comprobar que un envase está cerrado que detectar una pequeña grieta en una pieza móvil. El primer caso puede resolverse con una cámara y reglas visuales relativamente sencillas; el segundo puede requerir iluminación especializada, etiquetado de defectos y modelos de segmentación. Definir la necesidad con precisión permite establecer una prueba de viabilidad y descartar proyectos cuya información visual no resulta suficiente.
A continuación se revisan las condiciones reales de captura. El equipo debe evaluar posiciones de cámara, iluminación, velocidad de los objetos, variabilidad de materiales y disponibilidad de datos históricos. Es preferible recoger una muestra pequeña pero representativa de la actividad habitual, incluyendo los casos difíciles, que preparar una demostración sobre imágenes ideales. Después se decide si conviene utilizar procesamiento clásico, un modelo preentrenado o entrenamiento específico. Entre las herramientas habituales se encuentran OpenCV para operaciones de imagen y vídeo, PyTorch y TensorFlow para modelos de aprendizaje profundo y bibliotecas especializadas para tareas de detección o segmentación. Las plataformas comerciales también pueden resultar apropiadas, siempre que se comprueben sus funciones actuales, sus condiciones y su continuidad tecnológica.
La prueba piloto debe establecer indicadores acordes con el negocio. Si el objetivo es detectar defectos, pueden medirse la proporción de defectos identificados, las falsas alarmas, el tiempo por inspección y las incidencias que terminan requiriendo revisión humana. Si se trata de documentos, puede medirse la exactitud de campos críticos tras validación y el número de documentos que necesitan intervención. Además de la precisión, es necesario medir la estabilidad por turnos, categorías de producto y condiciones ambientales. Una prueba exitosa no consiste simplemente en que el sistema reconozca varias imágenes de ejemplo: debe demostrar que conserva un rendimiento aceptable durante un periodo y sobre una muestra representativa.
Con la viabilidad confirmada llega la integración con la operación. Un servicio de visión puede enviar resultados a un ERP, registrar una incidencia en una aplicación de mantenimiento o activar una comprobación adicional en una plataforma de almacén. Para estas conexiones se necesitan identificadores consistentes, permisos, tratamiento de errores y una trazabilidad que permita reconstruir decisiones. La infraestructura tecnológica de una empresa condiciona dónde conviene ejecutar el procesamiento: en un servidor local, en la nube o cerca de la cámara mediante Edge AI. La ejecución en el borde puede reducir la latencia y la transferencia de imágenes, pero exige administrar dispositivos distribuidos y sus actualizaciones.
Por último, el sistema necesita un responsable operativo, un protocolo para incidentes y revisiones periódicas del rendimiento. Cuando cambian referencias de producto o condiciones de captura, es posible que haya que actualizar los datos y volver a evaluar el modelo. También conviene definir qué sucede ante una caída de cámara o una predicción con baja confianza: continuar con inspección manual, detener una operación o abrir una alerta. La visión por computador funciona mejor cuando se diseña como parte de un proceso supervisado, no como una caja negra independiente cuyo resultado nadie puede comprobar.
El futuro de la visión por computador y la inteligencia artificial multimodal
La evolución de la visión por computador está acercando el análisis de imágenes a sistemas capaces de trabajar con distintas clases de información. Los modelos de visión y lenguaje pueden relacionar contenido visual con instrucciones escritas y generar descripciones o respuestas sobre una escena. Esto amplía los escenarios posibles: un técnico podría consultar qué componente aparece en una fotografía, comparar el resultado con un procedimiento de mantenimiento o pedir que se describa una anomalía detectada. No obstante, la explicación generada por un modelo multimodal debe verificarse cuando pueda afectar a una decisión crítica, porque interpretar una imagen y describirla con fluidez no garantiza que todos los detalles sean correctos.
Otra tendencia relevante es el procesamiento cerca de la fuente de captura. Edge AI permite ejecutar modelos en cámaras inteligentes, ordenadores industriales y dispositivos locales para reducir la dependencia de enviar cada imagen a la nube. Puede tener sentido cuando la respuesta debe producirse en milisegundos, la conectividad es limitada o conviene minimizar la transferencia de datos visuales. La disponibilidad de hardware específico y modelos optimizados está facilitando este enfoque, aunque cada caso debe valorar potencia, consumo, seguridad, capacidad de mantenimiento y necesidades de supervisión centralizada.
También avanzan los métodos que aprovechan modelos previamente entrenados y requieren menos datos etiquetados para ciertas tareas. Esto puede acelerar las pruebas de concepto, pero no elimina la necesidad de evaluar el comportamiento con imágenes propias del negocio. En sectores como la fabricación, la combinación de visión por computador, sensores y sistemas de gestión ofrece una perspectiva más completa que el análisis visual aislado. La siguiente etapa de madurez no consiste solo en reconocer más objetos, sino en integrar datos visuales fiables en procesos empresariales con criterios de seguridad, trazabilidad y responsabilidad definidos.
La inteligencia artificial ofrece nuevas posibilidades para mejorar la gestión empresarial cuando se integra con los sistemas que utilizan las organizaciones. Su conexión con un ERP permite aprovechar los datos de la empresa para automatizar tareas, agilizar operaciones y facilitar la toma de decisiones. En el siguiente vídeo puedes descubrir cómo se relacionan la inteligencia artificial y los sistemas ERP y qué oportunidades ofrece esta integración para las empresas.
Preguntas frecuentes sobre visión por computador
La visión por computador combina conceptos de inteligencia artificial, análisis de imágenes y automatización, por lo que es habitual encontrar dudas sobre su alcance y las herramientas necesarias para utilizarla. Las siguientes respuestas reúnen las diferencias más importantes y ayudan a entender qué expectativas son razonables antes de iniciar un proyecto. En particular, conviene distinguir la capacidad de reconocer patrones visuales de la capacidad de tomar decisiones autónomas, que depende de otros componentes y de las reglas de cada organización.
¿Qué es la visión por computador en inteligencia artificial?
La visión por computador es el campo de la inteligencia artificial dedicado a obtener información significativa de imágenes y vídeos. Puede clasificar fotografías, localizar objetos, interpretar texto escaneado o seguir elementos en movimiento. Para ello emplea técnicas tradicionales de procesamiento visual y, en numerosas aplicaciones actuales, modelos de machine learning y deep learning. Su objetivo no es simplemente mostrar una imagen, sino transformarla en datos que permitan describir, verificar o apoyar una decisión. La solución final puede incluir cámaras, software, servidores y conexiones con otros sistemas empresariales.
¿Qué diferencia hay entre visión artificial y visión por computador?
En español suelen utilizarse como sinónimos y comparten gran parte de sus métodos. En contextos industriales, «visión artificial» se asocia con frecuencia a sistemas de inspección y automatización que combinan cámaras, iluminación y equipos de control. «Visión por computador» suele hacer referencia a la disciplina informática más amplia, que también abarca investigación, análisis de escenas, robótica y aplicaciones digitales. No existe una separación terminológica universal, por lo que lo más útil es atender a la función de la solución: clasificar, detectar, medir, seguir o interpretar información visual.
¿Qué ejemplos de visión por computador existen?
Entre los ejemplos habituales se encuentran los sistemas que identifican productos defectuosos en una fábrica, leen números de serie, cuentan paquetes en almacenes, localizan objetos en vehículos y ayudan a analizar imágenes médicas. También se aplica a la digitalización de facturas mediante OCR y al análisis de cultivos captados con drones. Estos sistemas no tienen todos el mismo nivel de autonomía: algunos únicamente emiten una señal y otros están integrados con procesos que generan alertas o ejecutan acciones. Su utilidad debe evaluarse por la fiabilidad de la tarea concreta, no por lo avanzada que resulte la tecnología en términos generales.
¿Qué tecnologías se utilizan para desarrollar visión por computador?
Las herramientas dependen del problema. OpenCV permite preparar y analizar imágenes mediante funciones de procesamiento visual; PyTorch y TensorFlow facilitan desarrollar y adaptar modelos de aprendizaje profundo. Las redes convolucionales, los Vision Transformers y diversos modelos de detección o segmentación se utilizan para tareas de reconocimiento más complejas. También existen servicios comerciales y modelos preentrenados que pueden acelerar el desarrollo. Antes de seleccionar una tecnología conviene estudiar la calidad de los datos, los requisitos de precisión, la velocidad esperada y las condiciones de integración y mantenimiento.