La ventana de contexto es la cantidad máxima de información que un modelo de inteligencia artificial puede procesar de manera conjunta al elaborar una respuesta. En los modelos de lenguaje de gran tamaño o LLM, ese límite se expresa en tokens, pequeñas unidades en las que se divide el contenido. Cuanto mayor es la ventana, más conversación, documentos, instrucciones y datos puede recibir el sistema en una misma operación. Sin embargo, una capacidad superior no garantiza que utilice toda esa información con la misma precisión ni que la conserve de forma permanente.
Esta característica tiene consecuencias directas para las empresas que trabajan con asistentes inteligentes, buscadores documentales o agentes conectados a sus sistemas. Al diseñar una solución, no basta con elegir el modelo que admite más texto: hay que decidir qué datos necesita para cada tarea, qué información resulta confidencial y cómo comprobar las respuestas. Una consultoría de IA para empresas puede ayudar a definir esa arquitectura, conectar las fuentes corporativas adecuadas y establecer criterios de calidad, costes y seguridad antes de pasar a producción.
¿Qué es una ventana de contexto en inteligencia artificial y para qué sirve?
Una ventana de contexto delimita el volumen de información que un modelo puede tener disponible durante una solicitud o una secuencia de generación. Puede incluir el mensaje actual del usuario, conversaciones anteriores, instrucciones de comportamiento, documentos adjuntos, resultados de herramientas y, dependiendo del sistema, contenido multimodal representado mediante tokens u otras unidades computables. Es un concepto especialmente relevante en las arquitecturas basadas en transformadores, donde el modelo necesita relacionar elementos de la secuencia para producir una salida coherente.
Imaginemos un asistente al que se le pide revisar un contrato de cien páginas y contrastarlo con una política interna. Si ambos documentos, las instrucciones y el espacio necesario para responder caben en el límite disponible, el sistema puede recibirlos en una misma solicitud. Si el conjunto supera ese límite, será necesario seleccionar apartados, dividir el análisis o recuperar únicamente los fragmentos relacionados con la pregunta. La ventana de contexto no determina por sí misma si el análisis jurídico será correcto, pero condiciona cuánta evidencia puede consultar simultáneamente el modelo.
También influye en la continuidad conversacional. Un chatbot que atiende una incidencia puede necesitar datos facilitados al principio del diálogo, respuestas posteriores del cliente y consultas a un CRM. Cuando ese material ya no está disponible en el contexto activo, el sistema puede perder detalles o requerir un resumen. Por eso, en aplicaciones profesionales conviene diferenciar el límite técnico del modelo de la gestión de información que realiza la plataforma donde se utiliza.
¿Cómo funciona la ventana de contexto de un LLM?
Un LLM no interpreta directamente un documento como lo hace una persona que lee páginas completas. Primero recibe una representación tokenizada y, mediante su arquitectura, procesa las relaciones relevantes entre los elementos disponibles. La ventana delimita la longitud máxima admitida en ese procesamiento; la aplicación que utiliza el modelo, por su parte, decide qué mensajes, archivos y resultados se incluyen en cada llamada. Ambas capas condicionan la experiencia final y explican por qué dos herramientas basadas en un modelo similar pueden gestionar conversaciones extensas de manera diferente.
Tokens y tokenización: cómo se mide la ventana de contexto
Los tokens no equivalen necesariamente a palabras. Un token puede contener una palabra corta, una parte de otra, un signo de puntuación o determinados fragmentos de código. La misma expresión puede ocupar un número diferente de tokens según el tokenizador utilizado, el idioma y el formato del texto. Por ello, convertir 128.000 tokens en un número exacto de páginas sería engañoso: la longitud real dependerá del tipo de contenido, los caracteres especiales, las tablas y la forma de representar las entradas.
Para entender el límite conviene distinguir entre tokens de entrada, que contienen instrucciones, conversación y material de referencia, y tokens de salida, que forman la respuesta del modelo. Las fichas técnicas suelen publicar ambos límites por separado. Además, determinados sistemas incorporan tokens internos para operaciones de razonamiento o reservas de salida que afectan al presupuesto utilizable. Un ejemplo ilustrativo: aunque una aplicación admita una ventana de 128.000 tokens, no significa que podamos introducir 128.000 tokens de documentos y esperar una respuesta extensa sin reservar espacio para las demás partes de la solicitud.
El mecanismo de atención y la información que procesa el modelo
En un transformador, los mecanismos de atención ayudan a establecer relaciones entre diferentes posiciones de la secuencia. Así, una pregunta al final de un documento puede relacionarse con una definición presentada muchos párrafos antes. La arquitectura concreta determina cómo se calculan esas relaciones, qué optimizaciones se aplican y cómo se gestiona el crecimiento de la secuencia. La ventana de contexto marca el límite de entrada disponible, pero no constituye una garantía de atención uniforme sobre cada fragmento incluido.
Los sistemas modernos utilizan distintas técnicas para trabajar con secuencias largas, entre ellas variantes de atención, optimizaciones de memoria y mecanismos de reutilización de cálculos. Por eso no sería correcto afirmar que todos los modelos duplican exactamente su coste computacional del mismo modo cuando crece el contexto. La atención completa convencional presenta una complejidad cuadrática respecto a la longitud de la secuencia, pero las implementaciones actuales pueden introducir mejoras importantes. En cualquier caso, procesar más contenido suele aumentar las necesidades de recursos o el coste efectivo de la solicitud.
¿Qué ocurre cuando se supera el límite de la ventana de contexto?
Cuando una solicitud supera el máximo admitido, el comportamiento depende de la API o aplicación. Algunas interfaces rechazan la petición y muestran un error; otras recortan partes de la conversación, reducen el material adjunto o generan resúmenes para conservar lo que consideran más importante. No existe una regla universal según la cual todos los modelos eliminen automáticamente los mensajes más antiguos. Esa decisión suele formar parte de la gestión de contexto de la aplicación, no de una supuesta capacidad del modelo para decidir qué recordar de forma indefinida.
En un entorno empresarial, un recorte silencioso puede tener consecuencias importantes. Si un asistente deja fuera una excepción contractual, una política de devoluciones o la última modificación de un pedido, quizá genere una respuesta plausible pero incompleta. Para evitarlo, conviene establecer controles que avisen cuando se alcance el límite, comprobar qué información se ha enviado realmente al modelo y diseñar procedimientos de recuperación o resumen que preserven los datos críticos. Un resumen puede ser útil, aunque siempre supone una transformación de la información original y necesita validación cuando los detalles son esenciales.
¿Por qué los modelos de IA tienen un límite de contexto?
El límite existe por razones relacionadas con el diseño del modelo, su entrenamiento y los recursos necesarios para ejecutarlo. Procesar una secuencia implica almacenar representaciones intermedias, consultar información previa y generar nuevas unidades de salida. A medida que aumenta el contexto, crecen las exigencias de memoria y cálculo, aunque la magnitud exacta varía en función de la arquitectura, el hardware y las optimizaciones. Los fabricantes deben equilibrar capacidad, latencia, fiabilidad y coste, no solo anunciar el mayor número de tokens posible.
Hay, además, una dimensión de calidad. Un modelo puede aceptar una entrada muy extensa y aun así fallar al localizar una excepción escondida entre miles de líneas o al relacionar correctamente dos documentos alejados dentro de la secuencia. Por eso la evaluación de un proyecto no debería limitarse a comprobar que los archivos caben. Es necesario ensayar preguntas representativas, medir la recuperación de datos concretos y verificar si las conclusiones se apoyan en las fuentes correctas.
¿Qué diferencia existe entre ventana de contexto, memoria y tokens de salida?
Estos tres conceptos suelen mezclarse, especialmente cuando se habla de asistentes que mantienen conversaciones prolongadas. La ventana de contexto representa la información disponible para una operación; la memoria persistente es un mecanismo adicional que almacena ciertos datos fuera de esa operación para recuperarlos posteriormente; y los tokens de salida delimitan cuánto puede generar el modelo en una respuesta. Una herramienta puede disponer de memoria externa y, aun así, utilizar una ventana relativamente pequeña porque solo recupera los recuerdos necesarios para cada consulta.
También hay que diferenciar memoria de entrenamiento y contexto. Los patrones aprendidos durante el entrenamiento forman parte del comportamiento estadístico del modelo y no equivalen a una base de datos consultable de forma exacta. Cuando una empresa necesita que un asistente conozca una tarifa actualizada o un procedimiento aprobado ayer, resulta más apropiado conectarlo a fuentes controladas que confiar en lo que el modelo pudiera haber aprendido con anterioridad. La ventana será el espacio donde se introduzca esa evidencia recuperada, junto con la pregunta y las instrucciones para utilizarla.
Tamaño de la ventana de contexto de los principales modelos de IA
Las ventanas de contexto han aumentado de forma considerable, pero comparar cifras exige identificar el modelo exacto y la interfaz de acceso. Una misma familia puede ofrecer capacidades diferentes en una API, una modalidad empresarial o una aplicación de chat. También conviene distinguir el máximo admitido del rendimiento real con documentos extensos. La siguiente tabla muestra ejemplos documentados por sus fabricantes, no un ranking de calidad ni una garantía para todos los productos que llevan esas marcas.
Fuentes técnicas: OpenAI, ficha de GPT-5.4, Google, documentación de Gemini 2.5 Pro y Anthropic, ventanas de contexto. Estas especificaciones se han consultado en noviembre de 2026 y pueden cambiar con nuevas versiones o condiciones de acceso.
Para seleccionar un modelo es más útil realizar una prueba con la carga real del proyecto que decidir únicamente por la cifra de la tabla. Un asistente que clasifica solicitudes cortas quizá no necesite una ventana de cientos de miles de tokens, mientras que una herramienta de análisis jurídico o de revisión de repositorios extensos puede beneficiarse de ella. Incluso en este último caso, la estrategia de recuperación de información, el precio por token y la capacidad de citar el origen de las respuestas seguirán siendo decisivos.
Ventajas y limitaciones de las ventanas de contexto largas
Una ventana extensa permite abordar tareas que antes requerían dividir el contenido en numerosas operaciones. Facilita comparar documentos, conservar más historial conversacional y ofrecer al modelo instrucciones detalladas junto con material de referencia. Sin embargo, también puede incentivar una práctica poco recomendable: introducir grandes volúmenes de datos sin filtrar y asumir que el sistema encontrará siempre lo importante. La utilidad real depende de la calidad y de la organización de la información, además de la capacidad nominal del modelo.
Mayor capacidad de análisis de documentos y conversaciones
Cuando el contexto permite incluir varios informes, políticas internas o fragmentos de código relacionados, el modelo puede identificar conexiones que serían difíciles de detectar si solo recibiera secciones aisladas. Por ejemplo, un equipo de compras puede solicitar una comparación entre tres propuestas comerciales, un pliego técnico y la política corporativa de proveedores. Si toda la información relevante está disponible, el sistema tiene más oportunidades de señalar divergencias, localizar requisitos y explicar qué documento respalda cada observación.
En asistentes conversacionales, una ventana amplia también puede reducir la necesidad de resumir reiteradamente el historial. Esto resulta valioso en procesos de soporte donde cada interacción añade datos sobre el problema, pero no reemplaza una gestión cuidadosa del estado de la incidencia. Los hechos que deben perdurar, como una autorización o una fecha comprometida, conviene registrarlos en el sistema correspondiente y no depender exclusivamente de que permanezcan visibles dentro de una conversación.
Pérdida de información relevante y efecto Lost in the Middle
El fenómeno conocido como Lost in the Middle describe la dificultad observada en determinados modelos para utilizar información situada en las zonas intermedias de un contexto largo. Un estudio publicado en Transactions of the Association for Computational Linguistics comprobó que, en sus pruebas, algunos sistemas respondían mejor cuando la información relevante aparecía al principio o al final. No significa que todos los modelos actuales presenten el mismo comportamiento, ni que una sección central vaya a ignorarse siempre; es una advertencia sobre la diferencia entre admitir información y aprovecharla correctamente.
Para tareas empresariales exigentes es preferible evaluar la capacidad de recuperación con casos reales: una cláusula poco frecuente en el centro de un contrato, una incidencia en un historial extenso o una excepción de facturación que contradice la regla general. La prueba debe comprobar tanto si el modelo encuentra el dato como si evita inventar detalles cuando la evidencia es insuficiente. Véase el estudio Lost in the Middle: How Language Models Use Long Contexts.
Costes computacionales, latencia y seguridad
Enviar muchos tokens puede incrementar la factura de la API y el tiempo necesario para obtener una respuesta. También puede elevar la exposición de información si se incorporan documentos que el usuario no debería consultar. En escenarios conectados a ERP, CRM o repositorios internos, la política correcta no consiste en pasar toda la base de datos al modelo: debe limitarse el acceso por usuario, finalidad y necesidad operativa. La selección previa de fuentes, el enmascaramiento de datos y el registro de consultas forman parte del diseño del sistema.
Otra cuestión relevante es la inyección de instrucciones: un documento externo o una página recuperada puede contener texto diseñado para alterar el comportamiento del asistente. Cuanto mayor es el material que recibe, más importante resulta distinguir las instrucciones autorizadas de la información no confiable. Los controles de seguridad deben aplicarse en la capa de herramientas y permisos, no dejarse únicamente en manos de una indicación escrita dentro del prompt.
¿Cómo optimizar el uso de la ventana de contexto?
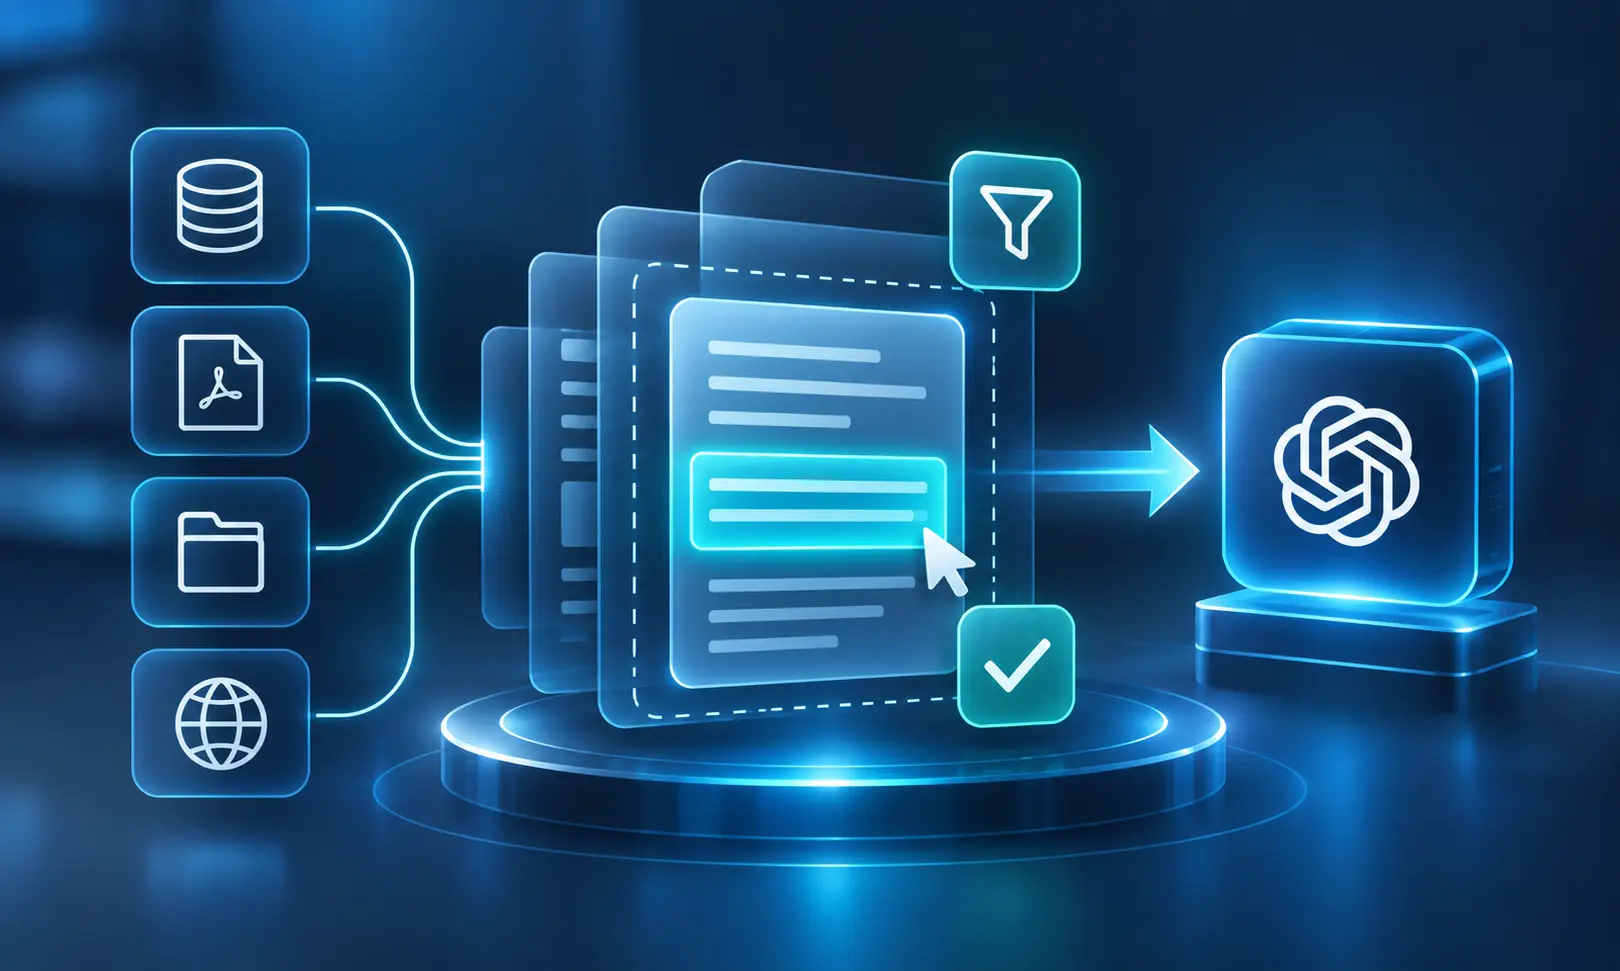
La optimización consiste en enviar al modelo la información suficiente para resolver la tarea, evitando contenido irrelevante, redundante o no autorizado. No se trata de acortar todo indiscriminadamente: un contrato complejo puede exigir conservar sus excepciones, y una auditoría necesitará referencias completas a la fuente. La decisión debe basarse en la finalidad del proceso, el riesgo de error y la posibilidad de recuperar más datos cuando hagan falta.
Ingeniería de contexto y selección de información relevante
La ingeniería de contexto organiza instrucciones, datos recuperados, estado de la tarea y resultados de herramientas para que el modelo reciba un conjunto coherente. Por ejemplo, un asistente de operaciones puede necesitar el pedido actual, las condiciones de entrega aplicables y una política de devoluciones, pero no todo el histórico comercial del cliente. Un buen diseño identifica las fuentes autorizadas, separa sus contenidos, elimina duplicados y especifica qué debe hacer el sistema cuando existen contradicciones.
También resulta útil establecer prioridades: primero las instrucciones operativas y restricciones del proceso, después los datos verificables relevantes para la tarea y, por último, el historial que aporte contexto. Estas prioridades no convierten automáticamente al modelo en infalible, pero hacen más fácil evaluar sus respuestas. En las aplicaciones productivas, conviene conservar identificadores de documentos y versiones para que una respuesta pueda revisarse posteriormente.
RAG, embeddings y recuperación de información externa
La generación aumentada por recuperación (RAG) permite buscar contenido en repositorios externos y enviar al modelo los fragmentos adecuados en lugar de cargar todos los documentos a la vez. Para localizar esos fragmentos pueden utilizarse búsquedas tradicionales, filtros estructurados y técnicas semánticas basadas en embeddings, representaciones numéricas que ayudan a comparar la similitud entre consultas y textos. El sistema recupera evidencia, la incorpora al contexto y genera una respuesta apoyada en ella.
Este enfoque es especialmente interesante para bases documentales grandes o cambiantes, aunque tampoco garantiza la ausencia de errores. Si la recuperación encuentra páginas desactualizadas o deja fuera una cláusula esencial, el modelo responderá con una base incompleta. De ahí la importancia de combinar búsquedas, aplicar permisos desde el origen, comprobar la actualidad de los documentos y medir la calidad de las respuestas. En organizaciones con múltiples aplicaciones, las integraciones mediante herramientas y protocolos como MCP pueden facilitar el acceso controlado a funciones concretas, tal como se explica en el artículo de Process Control sobre el servidor MCP de Odoo 20.
Fragmentación, resúmenes y memoria externa
La fragmentación de documentos o chunking divide el material en unidades con sentido, procurando no separar una definición de sus excepciones ni romper una tabla en partes difíciles de interpretar. Los resúmenes jerárquicos permiten trabajar primero con una vista general y recuperar las secciones detalladas solo cuando sean necesarias. Para conversaciones prolongadas, una memoria externa puede conservar datos relevantes y recuperarlos posteriormente en lugar de mantener la transcripción íntegra dentro del contexto activo.
Cada técnica introduce compromisos. Los fragmentos demasiado pequeños pierden relaciones; los demasiado grandes añaden ruido; los resúmenes pueden omitir matices; y la memoria persistente requiere criterios de conservación, actualización y eliminación. La arquitectura correcta combina estos mecanismos en función del caso de uso, con pruebas de recuperación y controles sobre la procedencia de cada dato.
Aplicaciones de las ventanas de contexto en las empresas
El impacto empresarial de la ventana de contexto se aprecia cuando la IA necesita trabajar con información acumulada: documentación contractual, conocimiento técnico, conversaciones de soporte o registros operativos. En estos escenarios, la cuestión esencial no es cuántas páginas admite un modelo en abstracto, sino qué información debe consultar para tomar una decisión concreta y cómo puede justificarse el resultado. La arquitectura puede combinar ventanas amplias con búsquedas específicas y memoria externa, sin necesidad de introducir todas las fuentes en cada interacción.
Análisis de documentos extensos e información corporativa
Un departamento jurídico puede comparar contratos con modelos de cláusulas; un equipo de recursos humanos, revisar políticas internas; y un responsable de calidad, contrastar procedimientos con registros de auditoría. En todos estos casos, disponer de más contexto puede evitar que el contenido se divida en demasiadas consultas aisladas. Aun así, el sistema debe identificar las versiones vigentes, respetar permisos y señalar las fuentes exactas que respaldan cada respuesta, especialmente si se utiliza para preparar decisiones de impacto económico o normativo.
La alternativa no siempre es cargar todos los archivos. Cuando la empresa dispone de miles de documentos, suele ser más razonable combinar un índice documental con recuperación selectiva y reservar el contexto largo para los casos en los que realmente es necesario comparar distintas fuentes. Esta elección reduce información redundante y permite evaluar con mayor claridad por qué el modelo ha llegado a una determinada interpretación.
Asistentes de IA, agentes inteligentes e integración con ERP y CRM
Un agente de atención comercial podría consultar el estado de un presupuesto en el CRM, comprobar el stock en el ERP y responder a una pregunta del cliente siguiendo las condiciones aprobadas. La ventana de contexto alojaría la solicitud, los datos recuperados y las instrucciones aplicables, mientras que los sistemas originales conservarían la información maestra. Este esquema ayuda a evitar que un historial conversacional se convierta en la única fuente de verdad de procesos que requieren trazabilidad.
Cuando se diseñan estos sistemas, resulta útil distinguir las capacidades de un asistente de las de un agente con permisos para ejecutar acciones. El artículo de Process Control sobre agentes de IA frente a asistentes de IA amplía esa diferencia. En ambos casos, el diseño del contexto debe ir acompañado de controles de acceso, validación de datos y supervisión humana para las operaciones sensibles.
¿Cómo elegir una ventana de contexto adecuada para un proyecto de IA?
La elección debe partir de una evaluación del caso de uso. Un clasificador de correos que analiza mensajes breves tiene necesidades distintas de un asistente que compara documentación técnica de varios departamentos. Antes de contratar un servicio conviene estimar cuántos tokens ocupan las instrucciones, los datos habituales y las respuestas esperadas; después, probar escenarios extremos que incluyan documentos largos, tablas, búsquedas fallidas y consultas contradictorias.
La evaluación debería medir precisión de las respuestas, recuperación de información, latencia, coste por operación, privacidad y facilidad de mantenimiento. También interesa conocer cómo gestiona la plataforma los límites: si rechaza entradas excesivas, si resume automáticamente el historial y si permite inspeccionar los fragmentos enviados. Una ventana mayor puede ser una ventaja, pero un sistema bien diseñado con recuperación selectiva puede rendir mejor en tareas concretas utilizando menos tokens y aportando una trazabilidad superior.
No existe una cantidad de contexto óptima para todas las empresas. En proyectos complejos, el tamaño de la ventana es solo una variable dentro de una arquitectura más amplia formada por fuentes de datos, permisos, herramientas, mecanismos de memoria y procesos de revisión. La decisión debe revisarse cuando cambien los modelos, los requisitos del negocio o el volumen de información disponible.
Comprender cómo los modelos de inteligencia artificial procesan la información es fundamental para aprovechar sus capacidades en entornos empresariales. La ventana de contexto determina qué cantidad de datos puede utilizar un modelo en cada operación y condiciona cómo trabaja con documentos, conversaciones y fuentes externas. En el siguiente vídeo puedes profundizar en este concepto y comprender mejor su importancia en las aplicaciones de IA.
Preguntas frecuentes sobre las ventanas de contexto
Las ventanas de contexto generan dudas porque las plataformas comerciales suelen resumirlas mediante cifras como 128K o un millón de tokens, sin explicar qué parte de ese espacio está realmente disponible para los documentos o cómo se conserva la información entre sesiones. También es frecuente confundir un aumento de capacidad con una memoria permanente o una mejora automática de precisión. Estas respuestas aclaran las diferencias más importantes para interpretar las especificaciones y elegir una solución de inteligencia artificial adecuada.
¿Cuántos tokens tiene una ventana de contexto?
Depende del modelo y de su versión. Existen ventanas de decenas de miles, cientos de miles y más de un millón de tokens. La cifra indicada en la documentación técnica representa una capacidad máxima bajo determinadas condiciones, no una cantidad fija de palabras o páginas. Conviene comprobar también los límites de salida y los requisitos específicos de la plataforma donde se utiliza el modelo.
¿Qué significa una ventana de contexto de 128K o 1 millón de tokens?
Significa que el modelo admite un presupuesto de contexto expresado en aproximadamente 128.000 o un millón de tokens, respectivamente. Ese espacio puede incluir las instrucciones, la conversación y la información recuperada, además de otros elementos que contabilice el proveedor. No significa que pueda generar una respuesta de esa misma longitud ni que recuerde permanentemente todo lo recibido.
¿Una ventana de contexto más grande significa que la IA es mejor?
No necesariamente. Una capacidad superior facilita procesar entradas extensas, pero la calidad depende también del razonamiento, de cómo se recupera la evidencia y de la fiabilidad con la que se utiliza. Un modelo con menos contexto puede responder mejor a una tarea específica si recibe información bien seleccionada. La comparación más útil se basa en pruebas con consultas representativas del negocio.
¿Qué pasa cuando ChatGPT alcanza su límite de contexto?
El comportamiento depende del modelo y de la modalidad de producto utilizada. La aplicación puede gestionar automáticamente la información disponible, resumir o dejar fuera partes antiguas, o impedir determinadas solicitudes que superen límites técnicos. Por eso no conviene dar por hecho que todos los mensajes anteriores permanecen íntegros en el contexto activo de cada respuesta. Para conservar información empresarial crítica, es mejor utilizar registros y fuentes externas controladas.
¿Cómo se puede ampliar la memoria de un modelo de IA?
Normalmente no se amplía modificando la ventana por encima del máximo admitido, sino diseñando una memoria externa que almacene información relevante y la recupere cuando sea necesaria. Pueden utilizarse bases de datos, resúmenes estructurados, historial seleccionado y sistemas RAG. Estos mecanismos necesitan controles de actualización, privacidad y borrado, además de pruebas que confirmen que recuperan correctamente los datos.
¿Qué diferencia hay entre una ventana de contexto y RAG?
La ventana de contexto es el espacio de información que el modelo puede procesar durante una operación. RAG es una técnica para localizar información en fuentes externas e introducir los fragmentos relevantes en ese espacio. No son alternativas excluyentes: un sistema puede utilizar una ventana amplia y RAG al mismo tiempo. La combinación permite trabajar con repositorios mayores que la ventana disponible sin enviar todos los documentos en cada petición.